Blick in die Blackbox
Machine-Learning-Algorithmen können zur Blackbox werden, wenn wir nicht exakt wissen, was sie vorhersagen. Dieser Artikel zeigt, wie das SHAP (SHapley Additive exPlanations) Package in Python verwendet werden kann, um sich erklärbaren Ergebnissen im Bereich des Machine Learning anzunähern.
Machine Learning wird heutzutage in vielen Kontexten verwendet. Wir erhalten Angebote für verschiedene Produkte, die wir kaufen könnten, Empfehlungen, was wir heute Abend sehen könnten, und vieles mehr. Manchmal passen die Vorhersagen zu unseren Bedürfnissen und wir kaufen oder sehen uns an, was angeboten wurde. Manchmal erhalten wir falsche Vorhersagen. Manchmal werden diese Vorhersagen in einem sensibleren Kontext getroffen als nur in Bezug auf das Schauen einer Sendung oder einen bestimmten Produktkauf. Zum Beispiel dann, wenn ein Algorithmus, der Einstellungsentscheidungen automatisieren soll, eine Gruppe diskriminiert. Amazon-Rekrutierer haben einen Algorithmus verwendet, der Frauen systematisch ablehnte, bevor sie zu Vorstellungsgesprächen eingeladen wurden [1].
Um sicherzustellen, dass wir wissen, was die von uns verwendeten Algorithmen tatsächlich tun, müssen wir uns genauer ansehen, was wir tatsächlich vorhersagen. Neue Methoden des erklärbaren Machine Learning eröffnen die Möglichkeit, zu untersuchen, welche Faktoren vom Algorithmus ausgiebig genutzt wurden, um zu den Vorhersagen zu kommen. Diese Methoden können zu einem besseren Verständnis dessen führen, was der Algorithmus tatsächlich tut, und ob er Spalten besonders berücksichtigt, die nicht viele Informationen enthalten sollten.
Beispiel
Um ein deutlicheres Bild der erklärbaren KI zu erhalten, gehen wir ein Beispiel durch. Der verwendete Datensatz besteht aus Kickstarter-Projekten und kann bei Kaggle [2] heruntergeladen werden. Kickstarter ist eine Crowdfunding-Plattform, auf der man ein Video oder eine Beschreibung über sein geplantes Projekt hochladen kann. Will man ein Projekt unterstützen, kann man dafür Geld spenden. Ich führe durch einen Algorithmus für Machine Learning, der vorhersagen soll, ob ein Projekt erfolgreich sein wird oder nicht. Interessant ist, warum der Algorithmus zu einer bestimmten Entscheidung gekommen ist.
Dieses Beispiel wird in Python sein. Zunächst müssen wir also einige Pakete importieren (Listing 1). pandas, NumPy, scikit-learn und Matplotlib werden häufig in Data-Science-Projekten verwendet. CatBoost [3] ist ein großartiger baumbasierter Algorithmus, der hervorragend mit kategorialen Daten umgehen kann und auch in den Standardeinstellungen [4] eine gute Performance aufweist. SHAP [5] ist das Paket von Scott M. Lundberg, dessen Einsatz uns ermöglicht, die Ergebnisse von maschinellem Lernen zu interpretieren. Verwendete Package-Versionen:
pandas 0.25.0
NumPy 1.16.4
Matplotlib 3.0.3
scikit-learn 0.19.1
CatBoost 0.18.1
SHAP 0.28.3
Werfen wir via kickstarter.head() einen Blick auf den Datensatz (Abb. 1).
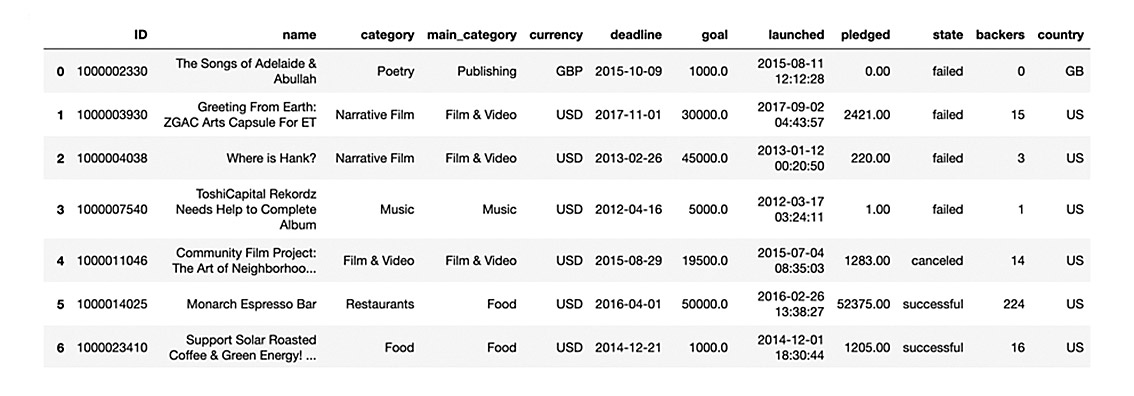 Abb. 1: Datensatz
Listing 1
import pandas as pd
import numpy as np
from sklearn.model_selection import train_test_split
import matplotlib.pyplot as plt
import catboost as catboost
from catboost import CatBoostClassifier, Pool, cv
import shap
Die erste Spalte ist die Identifikationsnummer jedes Projekts. Die name-Spalte ist der Name des Kickstarter-Projekts. Die category-Spalte klassifiziert jedes Projekt in eine von 159 verschiedenen Kategorien. Diese Kategorien lassen sich in 15 Hauptkategorien zusammenfassen. Die nächste Spalte ist die Währung (currency) des Projekts. Die deadline-Spalte stellt das letztmögliche Datum für die Unterstützung des Projekts dar. Die pledged-Spalte beschreibt den Geldbetrag, der zur Unterstützung des Projekts bereitgestellt wurde. Die state-Spalte ist der Zustand des Projekts nach dem Ablauf der Frist. Die backers-Spalte ist definiert als die Anzahl der Unterstützer für das jeweilige Projekt. Die letzte Spalte beinhaltet das Land (country), in dem das Projekt gestartet wurde. Wir werden an dieser Stelle nur die Zustände failed und successful verwenden, da andere Zustände wie canceled von geringerem...











