Mit der hierarchischen Abfragesprache des vorigen sowie dem Domänenmodell und dem Schema des ersten Kapitels war es einfach, komplexe Datenabfragen typsicher zu formulieren. Als nächste Aufgabe bleibt, die Abfrage am Backend gegen das jeweilige Data Storage zu mappen, in unserem Fall gegen eine relationale Datenbank.
In den beiden vorangegangenen Kapiteln haben wir TypeScript dank seines Metadatenkonzepts zu einer domänenspezifischen Sprache erweitert, in ebendieser unser Domänenmodell formuliert und daraus ein Domänenschema generiert. Mithilfe der TypeScript Union Types konnten wir schließlich eine Abfragegrammatik definieren und damit hierarchische Abfragen erstellen. Wir nennen sie – in Ermangelung eines kreativeren Namens – Mindruptive-Query-Language-Abfragen (MQL) und werden in diesem Kapitel betrachten, wie man sie automatisiert auf eine relationale Datenbank mappen kann.
Die Qual der Wahl – Welche Datenhaltung darfs denn sein?
Am Backend stehen uns verschiedenste Data Stores zur Verfügung: Angefangen von klassischen relationalen Datenbanken über NoSQL-Stores bis hin zu Graphdatenbanken wie Azure Cosmos Gremlin. Am einfachsten lassen sich hierarchische Abfragen natürlich auf NoSQL-Stores oder Graphdatenbanken abbilden. Einige der am Markt verfügbaren hierarchischen Abfragesprachen und deren Backend-Implementierung scheinen genau für NoSQL oder Graphdatenbanken optimiert zu sein. Im ersten Kapitel sind wir beispielsweise kurz auf die Vor- und Nachteile der resolve()-Funktionen in Facebooks GraphQL eingegangen, die 1:n-Beziehungen auflösen. Sie sind gewissermaßen opinionated, wie auf die Daten zugegriffen wird. Andere Datenzugriffsmodelle würden Workarounds benötigen oder Overhead verursachen. Eine der Grundmotivationen für die MQL in diesem shortcut ist, dem Entwickler die Freiheit zu lassen, selbst zu entscheiden, wie er auf welchen Data Store zugreift, auch auf relationale. Letztere sind nach wie vor in den meisten normalen (d. h. nicht weltweit mit Millionen von Benutzern skalierten) Applikationen im Einsatz. Daher verwenden wir für dieses einen Microsoft-SQL-Server, um zu zeigen, wie flexibel und leicht verständlich – ohne große Frameworkmagie – wir mit unserem Ansatz bleiben.
Das Datenmodell zum Domänenmodell
Das relationale Datenmodell in Abbildung 3.1 bildet das Domänenmodell der ersten beiden Kapitel ab.
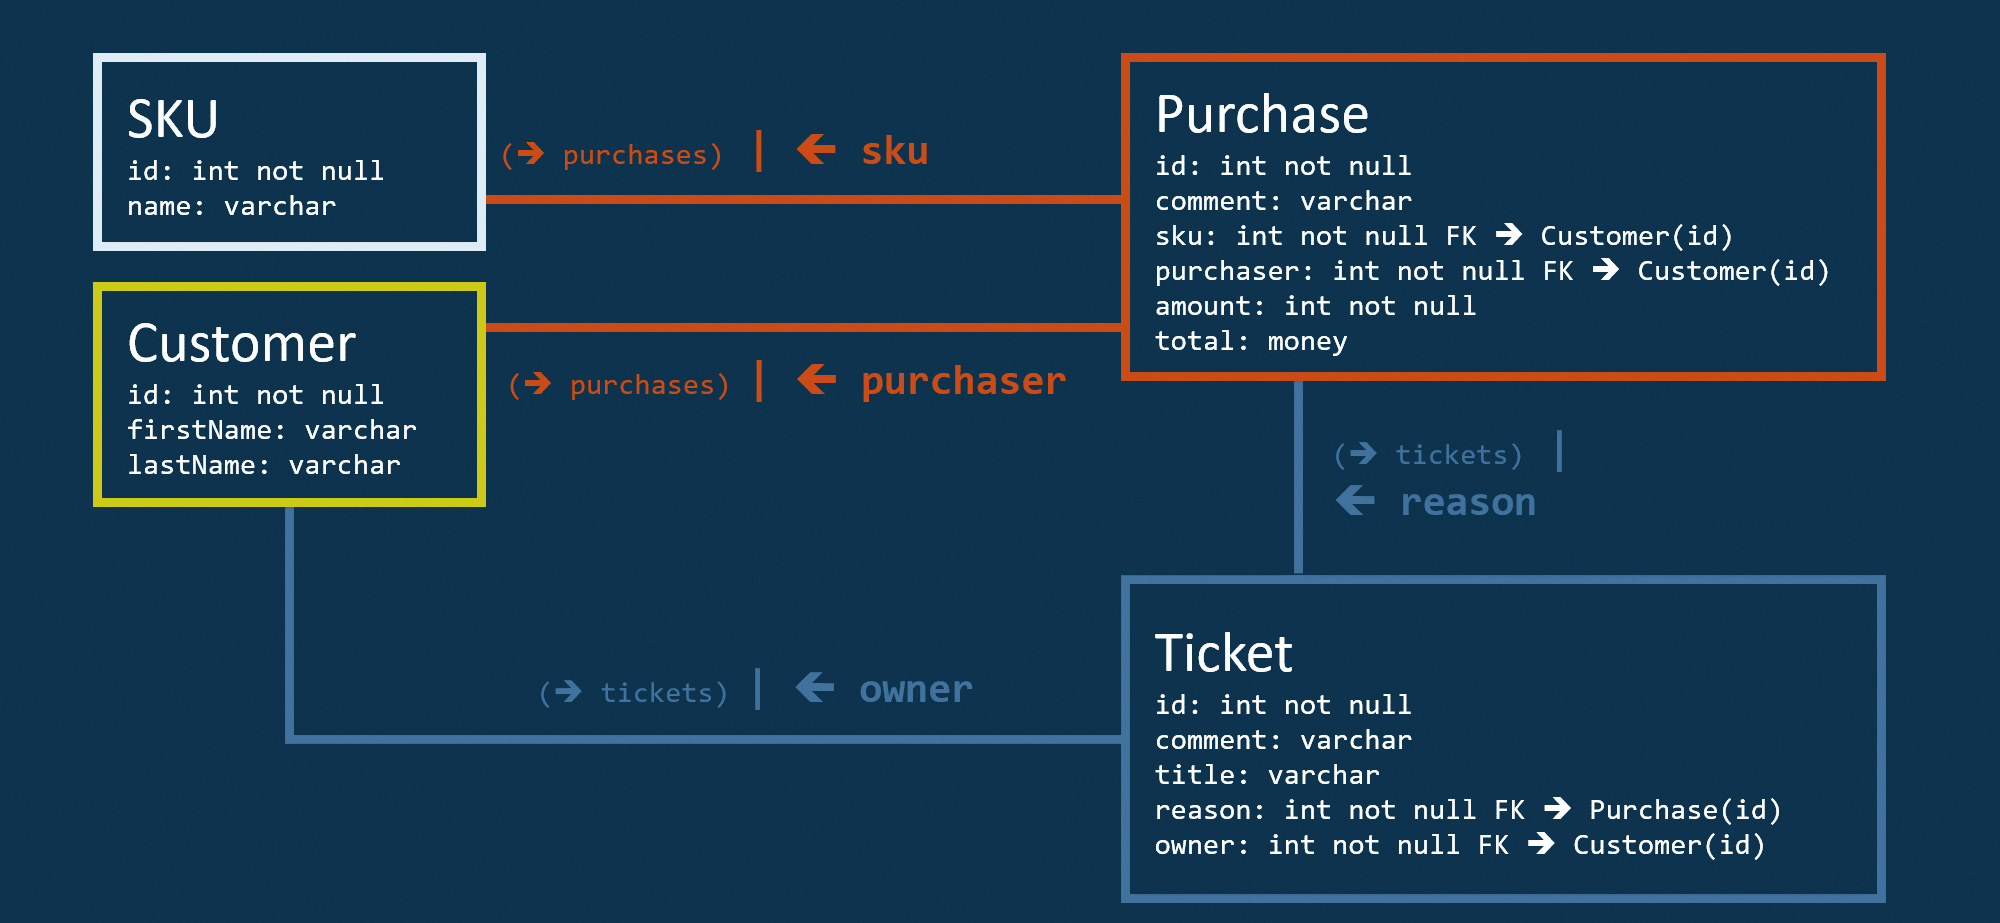
Abbildung 3.1: Das relationale Datenmodell; Umsetzung des Domänenmodells der ersten beiden Kapitel
Die 1:n-Beziehungen werden im relationalen Modell durch Foreign Keys auf der n-Seite umgesetzt, z. B. durch den Foreign Key purchaser der Entität Purchase. Würden wir unser Domänenmodell in einer objektorientierten Sprache wie TypeScript beschreiben, wüssten wir beim Mappen auf ein relationales Modell nicht genau, wie wir 1:n-Beziehungen auflösen sollen. Warum? Weil uns lediglich OO-Konzepte zur Beschreibung eines Objektmodells zur Verfügung stehen, z. B. Collection-artige Datenstrukturen. Dank der TypeScript-Metadaten aus dem ersten Kapitel können wir allerdings das Objektmodell zu einem Domänenmodell erweitern (Listing 3.1) und dort z. B. festlegen, dass die 1:n-Beziehung zwischen Customer und Purchase in beide Richtungen navigierbar ist und dass Purchase.purchaser das Inverse Property zu Customer.purchases ist. Dadurch haben wir die vollständigen Informationen zum Generieren des Data-Store-Zugriffs.
@DMClass({hideInMenu: false})
export class Customer implements ICustomer {
  @DMProp({isKey: true, validate: true})
  id: number;
  @DMProp()
  firstName: string;
  @DMProp()
  lastName: string;
  @DMProp <Purchase>({ label: "Einkäufe",
    contains: "Purchase",
    inverse: "purchaser" })
  purchases: Purchase[];
...
}
Listing 3.1: Domänenmodelklasse „Customer“, Fokus auf Property „purchases“
MQL-Abfragen auf das relationale Modell mappen: n+1-Query-Problem
In Listing 3.2 finden Sie eine MQL-Abfrage, die Kunden, Einkäufe und zugehörige Tickets abfragt:
- Alle Kunden, die („Satya Nadella“ oder „Bill Gates“ heißen) UND (in London oder Wien wohnen);
- Die Einkäufe jedes dieser Kunden
- Die Tickets jedes Einkaufs
- Die Einkäufe jedes dieser Kunden
import { schema } from "../../gen/schema";
import { Query, ROP, MOP, COP } from "../mql/mqlGrammar";
import { Customer, Purchase, SKU, Ticket } from "../../domainModel ";

// Define shortcuts for operators.
const AND = ROP.and;
const OR = ROP.or;
const EQ = COP.eq;
const GT = COP.gt;
const IN = COP.in;
const LIKE = COP.like;

// Get the class descriptors for domain classes and then their named properties.
const customerProps = schema.classes.Customer.props;
const purchaseProps = schema.classes. Purchase.props;
const skuProps = schema.classes.SKU.props;
const ticketProps = schema.classes.Ticket.props;

...
export const customerQuery: Query = {
  name: "Customers-Nadella-or-Gates",
  // Query customers
  class: "Customer",
  // Only return the following properties for the found customers:
  select: [customerProps.id, customerProps.firstName, customerProps.lastName],
  restrict:
  // (
  // (firstName == “Satya” AND lastName == “Nadella”) OR
  //   (firstName == “Bill” AND lastName == “Gates”)
  // ) AND (city IN [“Vienna”, “London”])
  {op: AND, restrict: [
    {op: OR, restrict: [
      // firstName == Satya AND lastName == Nadella
      {op: AND, restrict:[
        {property: customerProps.firstName,
        op: EQ , value: "Satya"},
        {property: customerProps.lastName,
        op: EQ , value: "Nadella"}
      ]},
      // firstName == Bill AND lastName == Gates
      {op: AND, restrict:[
        {property: customerProps.firstName,
        op: EQ , value: "Bill"},
        {property: customerProps.lastName,
        op: EQ , value: "Gates"}
      ]}
    ]},
    // city in ["Vienna", "London"]
    {property: customerProps.city, op: IN,value:["Vienna", "London"]},
  ],
  // Hierarchical sub-query: purchases of each customer
  expand: [
    {
      name: customerProps.purchases,     // customer -> purchases, 1:n
      select: [purchaseProps.id,
        purchaseProps.date,
        purchaseProps.title],
      // Hierarchical sub-query: The tickets for each purchase
      expand: [
        {
          name: purchaseProps.tickets,  // purchase -> tickets, 1:n
          select: [ticketProps .id, ticketProps.title],
        }
      ],
    }
  ],
}...
Listing 3.2: Modul „queries.ts“, Abfrage Customer -> Purchases -> Tickets
Die Herausforderung beim Mappen auf das relationale Modell besteht darin, dass wir die SQL-Querys möglichst effizient gestalten wollen. Wir wollen z. B. das n+1-Query-Problem vermeiden, das durch eine naive Datenzugriffsstrategie (Abb. 3.2) entsteht, die nur das Objektmodell, nicht aber das Datenmodell berücksichtigt. Es passiert dabei Folgendes:
- Im ersten SELECT laden wir die gesuchten Kunden. In unserem Beispiel sei die Anzahl der Ergebnisdatensätze 100.
- Pro Kunde laden wir seine Einkäufe: Dazu iterieren wir über die 100 Kunden und führen 100-mal eine Query auf die Tabelle Purchases aus. Die Anzahl der Ergebnisdatensätze sei durchschnittlich 20 pro Kunde. Wir haben daher bisher 1+100 Queries auf der Datenbank generiert.
- Danach laden wir die Tickets pro Einkauf: Wir iterieren über die durchschnittlich 20 Einkäufe und führen 20-mal eine Query auf Tickets aus. Wir haben bisher 1+100*20 Queries generiert. Die Anzahl der Ergebnisdatensätze sei durchschnittlich 10 pro Einkauf.
- Wie man leicht sehen kann, setzt sich das Muster fort: Wenn wir Zusatzinformationen zu den Tickets laden wollten, wären wir schon bei 1+100*20*10 Querys.
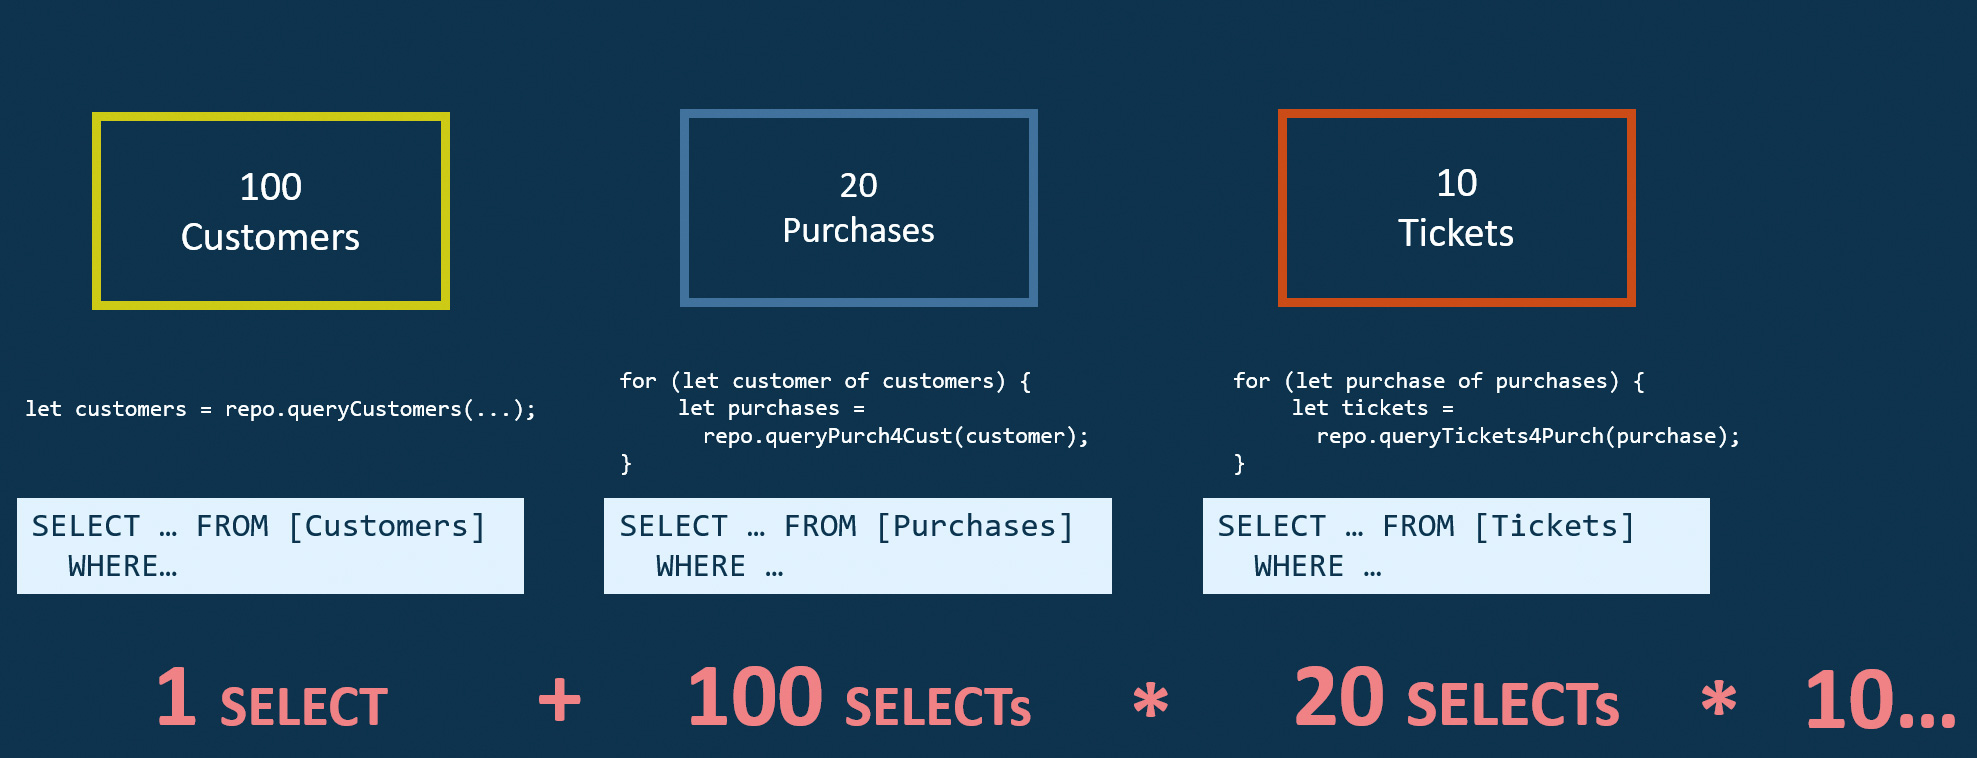
Abbildung 3.2: Polynomiale Laufzeitkomplexität und DB-Last, abhängig von der Anzahl der Datensätze
Diese Datenzugriffstrategie ist natürlich für jede nichttriviale Applikation ungeeignet. Probleme wie diese werden oft erst spät erkannt, da der Client seine Query korrekt absetzt und 08/15-Abfragen ohne sofort spürbare Konsequenzen bleiben. Erst wenn bestimmte Clients komplexere MQL-Abfragen absetzen, steigt die Last auf der Datenbank polynomial mit der Anzahl der Ergebnisdatensätze.
Datenbankabfragen optimieren: eine Abfrage pro hierarchischer Ebene
Wie könnten wir die obigen relationalen Abfragen optimieren? Wesentlich effizienter wäre es, pro hierarchischer Ebene der Abfrage Kunden | Einkäufe | Tickets nur mehr eine SQL-Abfrage zu benötigen. Die Abfrage skaliert dann mit der Anzahl der hierarchischen Ebenen statt mit der Anzahl die Ergebnisdatensätze.
Um zu den Einkäufen unserer gesuchten Kunden zu kommen, haben wir zwei effiziente (nicht n+1) Optionen:
- Einen Join zwischen Customers und Purchases. Dieser Join funktioniert zwar für eine Ebene gut, macht aber über mehrere Ebenen hinweg keinen Sinn, da wir mit Outer Joins arbeiten und so das Kreuzprodukt aus allen Ebenen erhalten würden.
- Ein SELECT, bei dem wir den Foreign Key purchaser mittels einer „IN“-Clause auf die IDs der zuvor gelieferten Kunden einschränken (Abb. 3.3). Ebenso würden wir mit den Tickets verfahren: Wir selektieren jene Tickets, deren Foreign Key reason innerhalb der IDs Einkäufe liegt, die wir eben geladen haben.
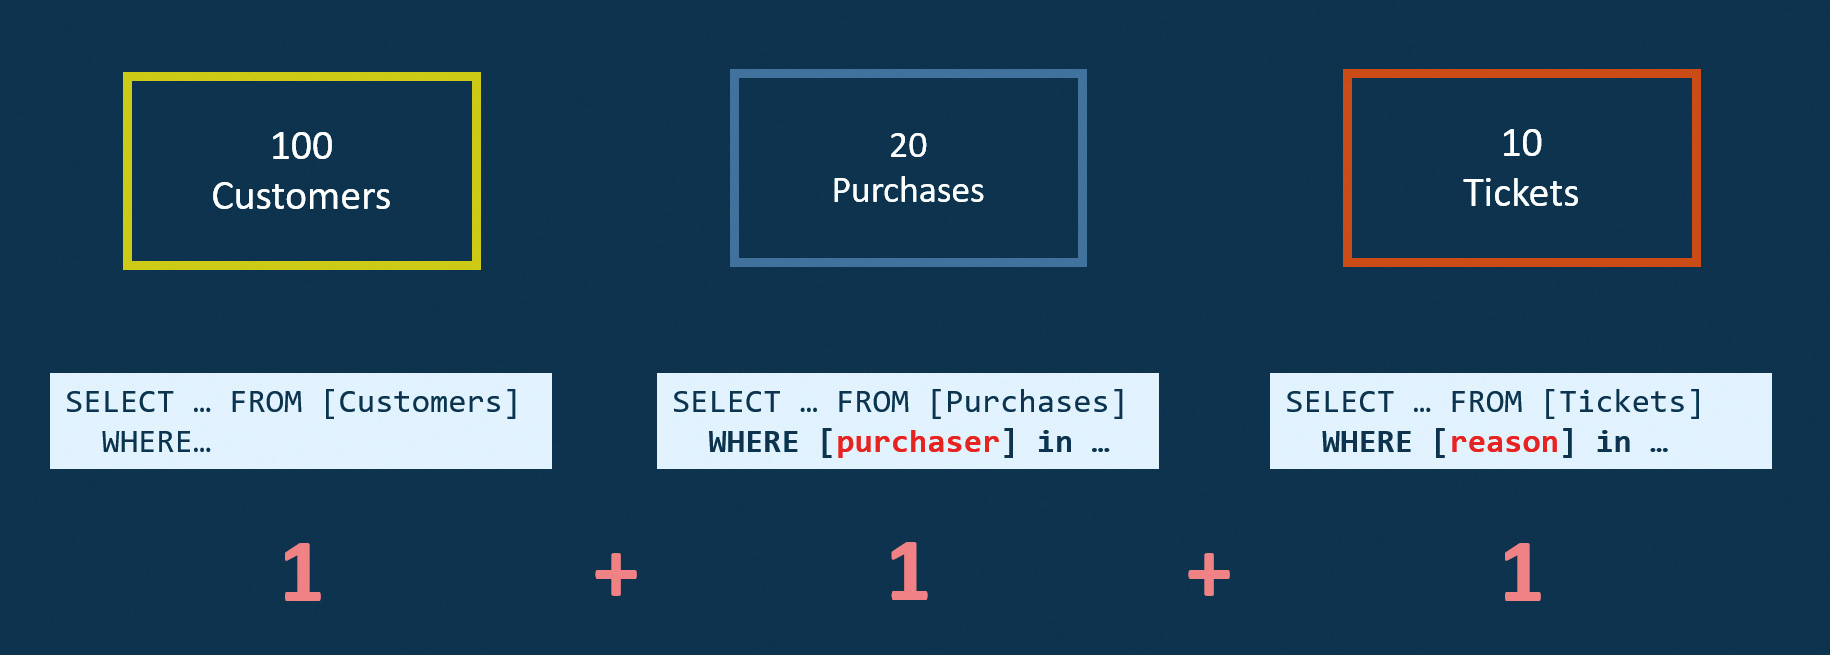
Abbildung 3.3: Lineare DB-Last, abhängig von der Anzahl der abgefragten hierarchischen Ebenen
Eine „IN Clause ohne IN Clause“: Tmp-Tabellen und Table-Variablen
Der SQL-affine Leser wird sofort anmerken, dass eine IN Clause – je nach Datenbank – nur für eine überschaubare Anzahl von IN-Einschränkungen sinnvoll ist und vor allem: Die IDs, die wir in der IN Clause anführen, müssen wir zuvor in den Speicher laden, um daraus eine IN Clause zusammenzubauen. Wir würden damit mit jeder Ebene unserer MQL-Abfrage (Kunden, Einkäufe, Tickets) einen Round-Trip zur Datenbank erzeugen. Können wir diesen Overhead nicht reduzieren und in einem einzigen Round-Trip die Einschränkungen direkt auf der Datenbank umsetzen? Mit temporären Tabellen bzw. Table-Variablen ist das möglich.
Wenn wir mit Tmp-Tabellen...











