TypeScript-Sprachkonstrukte ermöglichen es, mit überschaubarem Aufwand einen modellgetriebenen Ansatz aus folgenden Elementen zu etablieren: einem Domänenmodell, einem daraus erzeugten maschinenlesbaren Schema und einer pragmatischen, hierarchischen Query Language.
Webbasierte Applikationen haben sich zu Rich Clients entwickelt. Einer der Schwerpunkte bei datengetriebenen Rich Clients ist zweifellos ein möglichst effizienter und wartungsfreundlicher Datenaustausch mit Backends. Im Laufe der Zeit haben sich generische Abfragemethoden entwickelt, so z. B. OData, Facebook GraphQL oder Netflix Falcor. Da sie für möglichst breite Aufgabenstellungen konzipiert sind, bringen sie auch einen gewissen Overhead in Entwicklung und Ausführung mit sich. Wir wollen den Versuch wagen, mit den Konstrukten von TypeScript eine einfache, aber für die eigenen Bedürfnisse gut anpassbare Abfragesprache zu definieren. Die Basis dafür bildet ein Domänenmodell, das normale TypeScript-Klassen um Metadaten anreichert und aus dem ein maschinenlesbares Schema erzeugt wird. Letztendlich werden wir die in dieser Abfragesprache definierten Queries am Backend generisch auf eine relationale Datenbank mappen und das Ergebnis am Client typsicher verarbeiten. Durch die durchgängige TypeScript-Verwendung ersparen wir uns viel Overhead und schaffen Freiheitsgrade bei Design und Umsetzung.
Wissensmanagement oder Enterprise Relationship Management
Lassen Sie uns mit einem Beispiel aus der Praxis starten: In einem System, in dem es grob gesagt um das effiziente Verwalten und Wiederauffinden von Wissen oder Enterprise Relationship Management im weitesten Sinne geht, wird eine Vielzahl von Objekten logisch in einer netzwerkartigen Struktur gespeichert (Abb. 1.1).
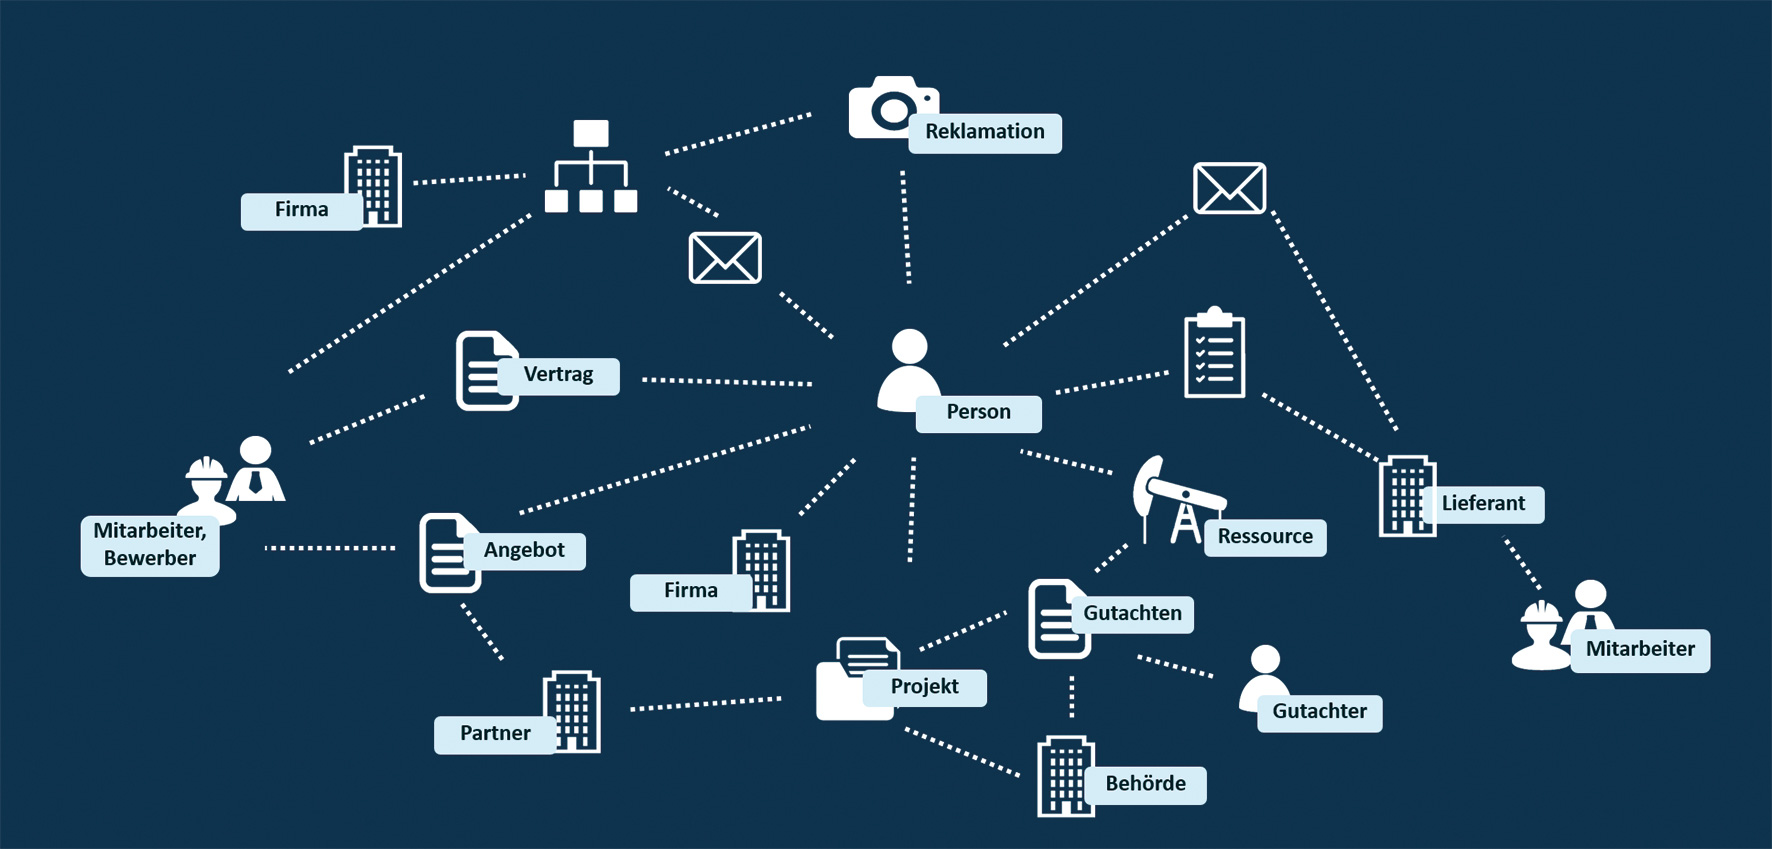
Abbildung 1.1: Verwaltung eines Wissensnetzwerks, einer Ontologie
Die physische Speicherung soll jetzt noch nicht relevant sein, sondern nur, dass die Objekte sehr stark miteinander vernetzt sind: Personen, Kunden, Lieferanten, Verträge, Angebote, Mails, Projekte, Teilprojekte, Telefonate, Ressourcen, Aufgaben, Termine, Mitarbeiter und viele mehr. Schaut man sich das Ganze aus einer Domain-driven-Design-Sicht an, fällt schnell auf, dass sich keine klare hierarchische Struktur oder Aggregate Root finden lässt. Je nachdem, wer in welcher Rolle und welchem Anwendungsfall darauf sieht, ergeben sich beliebig viele Einstiegspunkte in das Beziehungsnetzwerk. Ein Projektleiter wird z. B. vorrangig über das Projekt einsteigen und will von dort aus möglichst schnell die zugehörigen Informationen finden. Ein Vertriebsmitarbeiter ist dagegen fast ausschließlich an der Sicht auf seine Kunden interessiert.
Das Grundproblem: Endpoint Mania, Data Overfetching und Underfetching
Wie man sich leicht vorstellen kann, ist nicht nur die endanwenderfreundliche User Experience eine Herausforderung, sondern auch, wie man die Datenabfragen möglichst effizient gestaltet. Abbildung 1.2 zeigt einen naiven Ansatz: Von einem REST-Endpunkt wird zunächst „meine Kunden“ (eine Liste mit den IDs und Grunddaten der Kunden) geladen, danach werden die für den jeweiligen Screen relevanten Daten jeweils wieder über einen REST-Endpunkt geladen: die Anzahl der Einkäufe des Kunden, seine Stars (Bewertungen) usw.
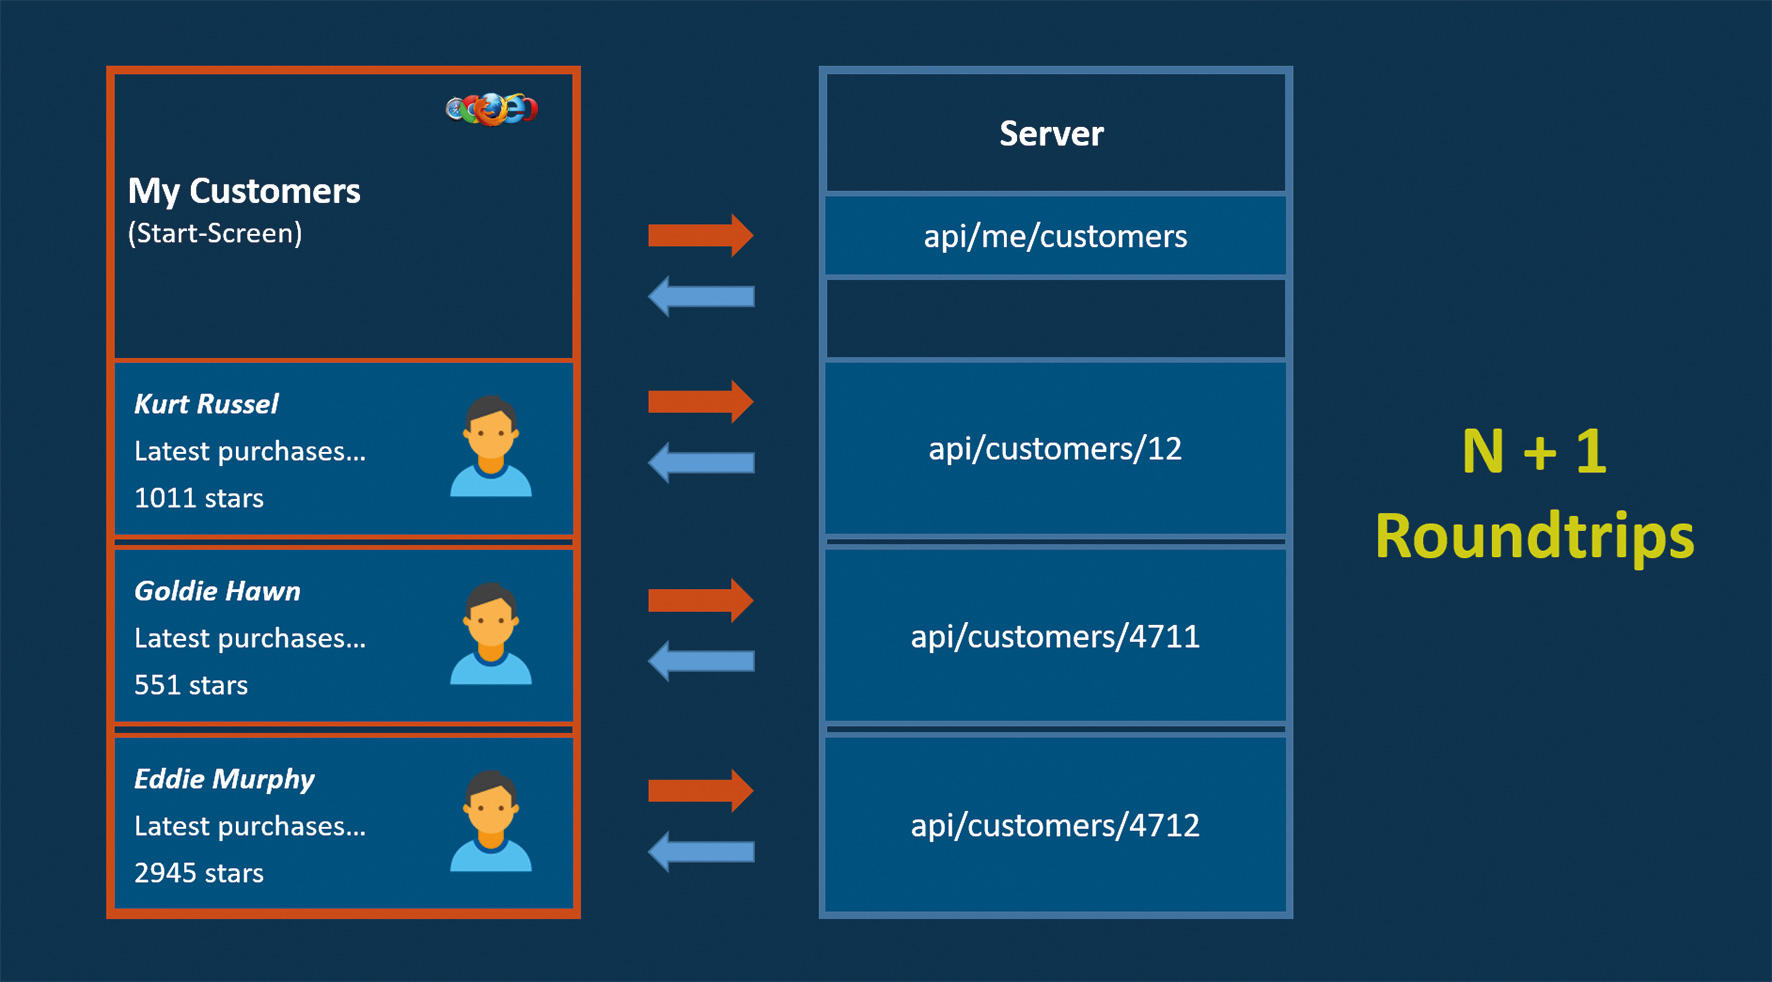
Abbildung 1.2: Ein naiver Ansatz, der N+1 Roundtrips verursacht
Dieser naive Ansatz ist zur Laufzeit natürlich nicht haltbar: Wir verursachen N+1 Roundtrips vom Client zum Server und potenziell auch zur Datenbank.
Ein anderer, ebenfalls naiver Ansatz wäre es, alle benötigten Daten für den Screen auf einmal zu laden, z. B. in einem REST-Endpunkt: „Lade alle Kunden und ihre Zusatzdaten für den Screen ‚Meine Kunden‘“. Wenn wir dann einen weiteren Use Case oder Screen, z. B. „Kunden mit offenen Bug-Anfragen“ umsetzen, benötigen wir wieder etwas andere Daten, beispielsweise die Anzahl der offenen Bugs des Kunden oder seine Kundenzufriedenheit. Für diesen Fall liefert unser zuvor verwendeter Endpoint zu wenige Daten: sogenanntes Underfetching liegt vor. Wenn wir immer genau die passenden Daten pro Screen laden wollen, laufen wir schnell in eine Endpoint Mania (viele Endpoints für viele Use Cases), die unsere App nach kurzer Zeit unwartbar macht.
Last but not least versuchen wir es gleich mit dem Ansatz „alles in Bausch und Bogen“: Wir laden sämtliche Daten, die wir zu einem Kunden benötigen: Grunddaten, Anzahl der Käufe, seine Stars, Anzahl der offenen Bugs, seine Zufriedenheit usw. Offensichtlich haben wir dann aber ein Overfetching, denn von all den geladenen Daten benötigen wir pro Screen nur einige wenige. Wir stecken in einem Dilemma: Viele kleine CRUD-ähnliche Services oder große/breite Services mit umfangreichen Rückgabemengen.
Navigieren im Netzwerk, jetzt wird’s hierarchisch
Zusätzlich zur Endpoint Mania und zum Over- oder Underfetching kommt noch, dass wir oft auch „zu N“-Beziehungen eines Kunden laden und anzeigen müssen, z. B. nicht nur die Anzahl seiner Einkäufe, sondern die letzten drei Käufe inklusive Detailinformationen. Eine Alternative zu vielen Service Endpoints wäre eine generische und hierarchische Abfragesprache wie die im Pseudocode in Listing 1.1. Mit ihr können wir bestimmen, welche Kunden, welche Felder und welche untergeordneten („zu N“) Daten wir benötigen, und so verschiedenste Screens und Use Cases bedienen. Wir optimieren dabei sowohl die Netzwerk-Roundtrips als auch die Wartbarkeit.
...










