
Weg mit Blockaden und Komplexität!
Kotlin ist aus der Android-Entwicklung nicht mehr wegzudenken, und auch im Backend nimmt es Fahrt auf. Neben der kompakten Kotlin-Syntax versprechen Koroutinen, das Entwicklerleben zu vereinfachen. Sie ermöglichen es, nichtblockierende Anwendungen zu schreiben, ohne mit dem gewohnten Programmierparadigma zu brechen.
Die Beispiele für diesen Artikel sind – wenig überraschend – mit Kotlin geschrieben. Im Kasten „Kotlin kompakt“ sind die wichtigsten syntaktischen Unterschiede zu Java zusammengefasst, und unter [1] findet sich eine gute Referenz für den tieferen Einstieg in die Sprache.
Kotlin kompakt
Den meisten Java-Entwicklern wird es nicht schwerfallen, Kotlin-Code zu lesen. Für alle, die sich noch nicht mit der Kotlin-Syntax beschäftigt haben, hier die wichtigsten Punkte zum Verständnis der Beispiele.
-
val definiert final-Variablen. Der Datentyp kann weggelassen werden oder wird nach dem Namen durch einen Doppelpunkt getrennt angegeben (Listing 1).
-
fun definiert Funktionen. Diese können auch global definiert werden (Listing 1).
-
Unit ist ein Datentyp mit genau einer Instanz und wird benutzt, wenn eine Funktion nichts Sinnvolles zurückliefert, entspricht in etwa void (Listing 2).
-
Klassen werden wie in Java durch class definiert. Bei der Vererbung wird kein extends oder implements angegeben, sondern ein Doppelpunkt (Listing 6).
-
Unveränderliche Properties werden innerhalb von Klassen mit val definiert (Listing 6).
-
Objekte werden ohne new erzeugt (Listing 6).
Funktionstypen und Lambdas
Während die ersten Punkte vermutlich leicht zu verstehen sind, ist der Unterschied bei Lambdas zwischen Kotlin und Java größer:
-
Kotlin unterstützt Funktionstypen und kommt ohne Functional Interfaces aus (Listing 2):
fun applyIntOperation (a: Int, b: Int, operation: (Int, Int) -> Int) {
  operation(a, b)
}-
Ist der Funktionsparameter der letzte Parameter, kann das Lambda außerhalb der Parameterklammern angegeben werden. Der letzte Ausdruck im Lambdablock ist automatisch das Ergebnis des Lambdas (Listing 2).
applyIntOperation(1, 2) { a, b -> a + b }-
Die Parameterklammern können auch weggelassen werden, wenn keine sonstigen Parameter vorhanden sind. Besitzt ein Lambda nur einen Parameter, muss dieser nicht definiert werden und bekommt automatisch den Namen it (Listing 1):
listOf(1,2,3).filter { it % 2 == 0 }.map { it * it }-
Beim Aufruf von Lambdas kann ein eigener this-Zeiger übergeben werden (Listing 8):
with(person) { // this ist jetzt 'person'
  println(name) //name ist Attribut von 'person'
}
Was ist eigentlich das Problem?
Damit die nachfolgende Diskussion nicht anhand von abstrakten Beispielen stattfindet, starten wir mit einem konkreten Szenario: Wir wollen einen Web Service für die Erstellung von Bildercollagen entwickeln. Mit Hilfe einer Suchmaschine werden mehrere Bilder für einen wählbaren Begriff ermittelt und zu einem neuen Bild zusammengefügt. Der Ablauf wird wie folgt aussehen:
Ermitteln von mehreren Bild-URLs über eine Suchmaschine
Laden der einzelnen Bilder
Kombinieren der Bilder zu einer Collage
Eine klassische Umsetzung könnte wie in Listing 1 aussehen, die einzelnen Schritte sind gut zu erkennen.
Listing 1
fun createCollage(query: String, count: Int): BufferedImage {
  val urls = requestImageUrls(query, count)
  val images = urls.map { requestImageData(it) }
  return combineImages(images)
}
Nachdem diese Version in Betrieb genommen wurde und der Service immer beliebter wird, bemerken wir jedoch ein Problem mit der Skalierbarkeit. Unter Last werden einzelne Clients abgewiesen; und das, obwohl ein großer Thread-Pool konfiguriert wurde. Ein Blick ins Monitoring offenbart kaum CPU-Auslastung, dafür ist der Speicherbedarf unserer Anwendung erstaunlich hoch.
Vermutlich ist vielen Lesern das Problem bereits offensichtlich. Der Service tut selbst sehr wenig, er wartet die meiste Zeit auf Antworten von anderen Servern. Abbildung 1 veranschaulicht das Problem.
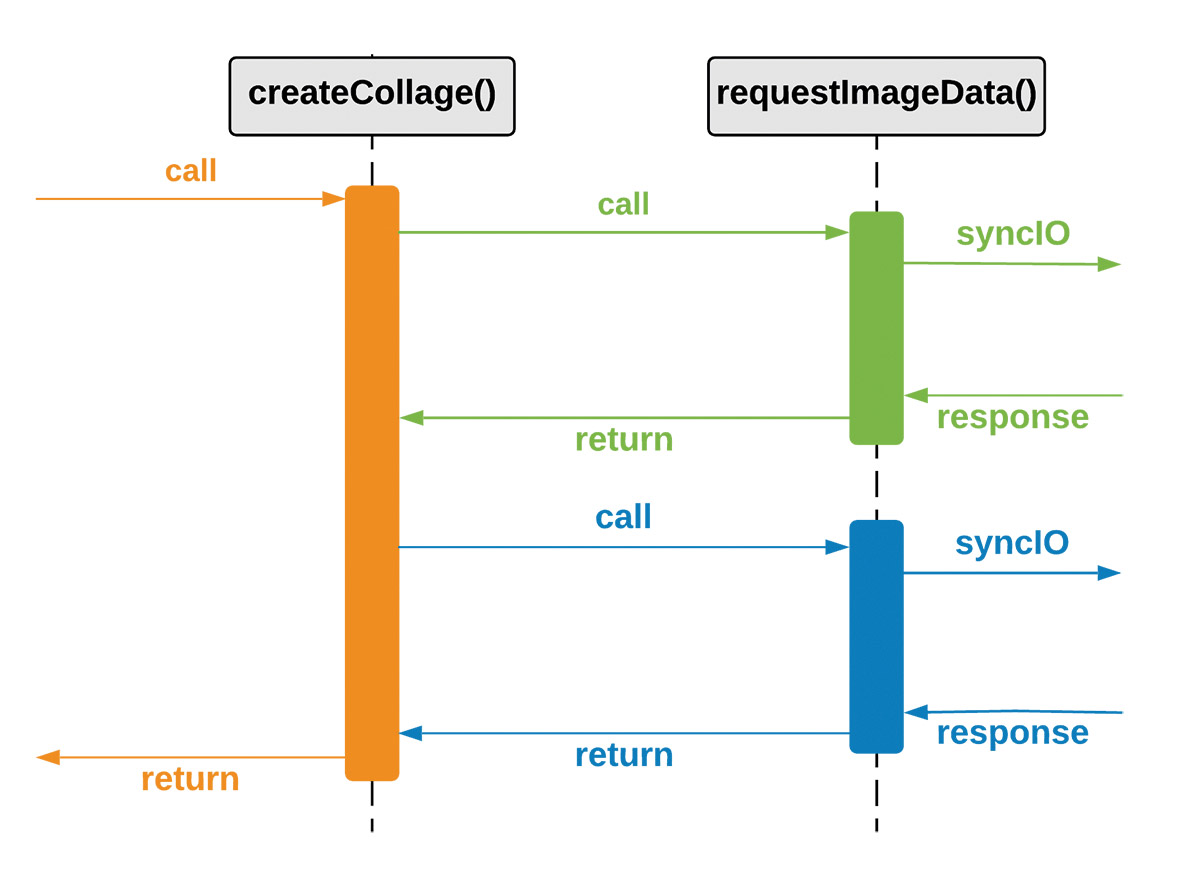 Abb. 1: Blockierende Threads bei synchronen Remote-Aufrufen
Die Funktion createCollage ruft für jedes Bild die Funktion requestImageData auf. Diese nutzt eine blockierende, synchrone HTTP-Bibliothek, um die Bilder zu laden. Bei vielen parallelen Clientzugriffen werden somit alle Threads aus dem Pool benutzt. Jeder Thread wartet auf den Download der Bilder und belegt Speicher für den eigenen, pausierten Aufrufstack. Neue Clients erhalten irgendwann keinen Thread mehr und müssen aufgeben.
Asynchrone APIs mit Callbacks und reaktiven Streams
Die Lösung für dieses Problem ist schon sehr lange bekannt: asynchrone IO-Zugriffe: der Thread wird während des Wartens auf die Antwortdaten freigegeben und steht somit anderen Clients zur Verfügung. Asynchrone IO-Bibliotheken geben typischerweise ihre Ergebnisse mittels Callbacks oder mit Futures/Promises/reaktiven Streams an den Aufrufer zurück. Ein Beispiel für eine Callback-API ist in Listing 2 zu sehen. Der Verständlichkeit halber wird nur ein Bild geladen. Aber man kann schon erahnen, wie die Verschachtelung mit jedem weiteren asynchronem Aufruf zunimmt. Wenn dazu noch Schleifen und Bedingungen kommen, ist man in der Callback-Hölle angekommen.
Listing 2
fun loadOneImage(query: String, callback: (BufferedImage) -> Unit) {
  requestImageUrl(query) { url ->
    requestImageData(url) { image ->
      callback(image)
    }
  }
}
Futures umgehen das Verschachtelungsproblem von Callbacks, indem sie die Callbacks in einem Objekt verpacken und es als Return-Wert zurückgeben. So wird es...










