
Einfacher, schneller, besser?
Amazon Kinesis ist hierzulande eher unbekannt. Zu Unrecht! In diesem Artikel werfen wir einen ausführlichen Blick auf die Kinesis-Produktfamilie und berichten aus Erfahrung über die Vor- und Nachteile von Amazon Kinesis Data Streams im Vergleich zu Apache Kafka. Wer macht das Rennen?
Amazon Kinesis, genauer gesagt Amazon Kinesis Data Streams, ist Amazons Antwort auf Apache Kafka – dem De-facto-Standard im Bereich Realtime-Data-Streaming. Hierzulande weniger bekannt, findet Amazons Apache-Kafka-Alternative vor allem in den USA Verwendung, liegt jedoch, was die Nutzerzahlen anbelangt, deutlich abgeschlagen hinter Apache Kafka auf Platz 2. Woran liegt das und lohnt sich dennoch auch hierzulande ein Blick auf Amazon Kinesis? Diese und viele weitere Fragen beantwortet dieser Artikel. Der Fokus liegt dabei auf Amazon Kinesis Data Streams und besonders auf dem Vergleich zu Apache Kafka. Allerdings werden auch die anderen Services von Amazon Kinesis kurz vorgestellt, sodass ein erster Eindruck über das gesamte Leistungsspektrum als Ausgangspunkt für eine weiterführende Recherche ermöglicht wird.
Amazon Kinesis wurde Ende 2013 als Service der Amazon Web Services (AWS) für die Realtime-Prozessierung von Data Streams vorgestellt. Auch wenn die Bezeichnung Amazon Kinesis häufig stellvertretend für Amazon Kinesis Data Streams, dem eigentlichen Streaming-Service (also der Alternative zu Apache Kafka), genutzt wird, umfasst Amazon Kinesis darüber hinaus noch weitere Produkte: Kinesis Video Streams, Kinesis Data Firehose und Kinesis Data Analytics. Doch dazu später mehr. Genutzt wird Amazon Kinesis beispielsweise von Größen wie Netflix, Comcast, Adobe, Thomson Reuters, aber auch von vielen kleineren Unternehmen. Gerade in jüngster Zeit hat Amazon Kinesis wegen eines Ausfalls in Nord-Virginia (Region us-east-1) für Schlagzeilen gesorgt. Obwohl von dem Ausfall nur eine der 24 AWS-Regionen betroffen war, waren am Mittag des 25. Novembers 2020 verschiedene Services von Anbietern wie Adobe, Roku, Flickr, Coinbase, Garmin und Amazons eigenes Health Dashboard nicht länger erreichbar oder funktionsfähig [1], [2]. Dieses außergewöhnliche Ereignis wirkt auf den ersten Blick abschreckend – setzt man jedoch diesen Ausfall in Relation, zum Beispiel zu Ausfallzeiten anderer Managed-Apache-Kafka-Anbieter, ist dieses Ereignis erheblich weniger eindrucksvoll, vom Vergleich zu selbstbetriebenen (Apache-Kafka-)Clustern mal ganz zu schweigen.
Als Teil von AWS ist eine Evaluierung von Amazon Kinesis nur sinnvoll, wenn im eigenen Unternehmen bereits AWS eingesetzt wird oder zumindest der Einsatz von AWS auf dem Fahrplan steht. Wenn die Cloud aus welchen Gründen auch immer nicht in Frage kommt, lohnt sich ein Blick auf Amazon Kinesis nicht: Im Gegensatz zu Apache Kafka steht Amazon Kinesis nicht on-prem zur Verfügung und kann somit nicht losgelöst von AWS betrieben werden. Finden dahingegen verschiedene Services von AWS bereits Anwendung oder ist ein Einsatz geplant, sollte Amazon Kinesis bei einer Evaluierung von (Realtime-)Event-Streaming-Technologien ganz oben auf der Liste stehen. Doch eins nach dem anderen: Worin unterscheiden sich die einzelnen Services „Data Streams“, „Data Firehose“ usw. und wie funktioniert Amazon Kinesis Data Streams überhaupt?
Die vier Musketiere
Amazon Kinesis ist der Überbegriff für vier Services, die sich im Kern alle um Realtime-Streaming drehen und sich gegenseitig ergänzen: Video Streams, Data Streams, Data Analytics und Data Firehose. Bei Amazon Kinesis Video Streams geht es, wie der Name bereits vermuten lässt, um das Bereitstellen, Verarbeiten und die Analyse von Video-Streams von diversen Geräten in Echtzeit, unter anderem in Kombination mit Machine Learning (z. B. Echtzeit-Computer-Vision-Funktionen). Amazon Kinesis Data Streams ist der Fokus dieses Artikels und bezeichnet einen skalierbaren und vollständig verwalteten Service für das Streaming von Datensätzen in Echtzeit. Amazon Kinesis Data Analytics bietet die Möglichkeit, Anwendungen entweder auf Basis von SQL oder mit Apache Flink zu erstellen (Abb. 1). Apache Flink ist ein Framework und eine verteilte Processing Engine für zustandsbehaftete Berechnungen über Batch- und Event-Datenströme. Die Stärken von Flink sind Berechnungen mit In-Memory-Geschwindigkeiten und die hohe Skalierbarkeit. Außerdem lassen sich über den gesonderten Plan Visualizer-Flussdiagramme der einzelnen Bearbeitungsschritte in Flink visualisieren. Geht es um typische Datenintegrationsszenarien und somit um die Anbindung von Datensenken, z. B. Amazon Redshift, Elasticsearch oder Drittanbieter, kommt Amazon Kinesis Data Firehose ins Spiel. Der vollständig verwaltete Service übernimmt dabei Skalierung, Sharding und Überwachung der internen Streams.
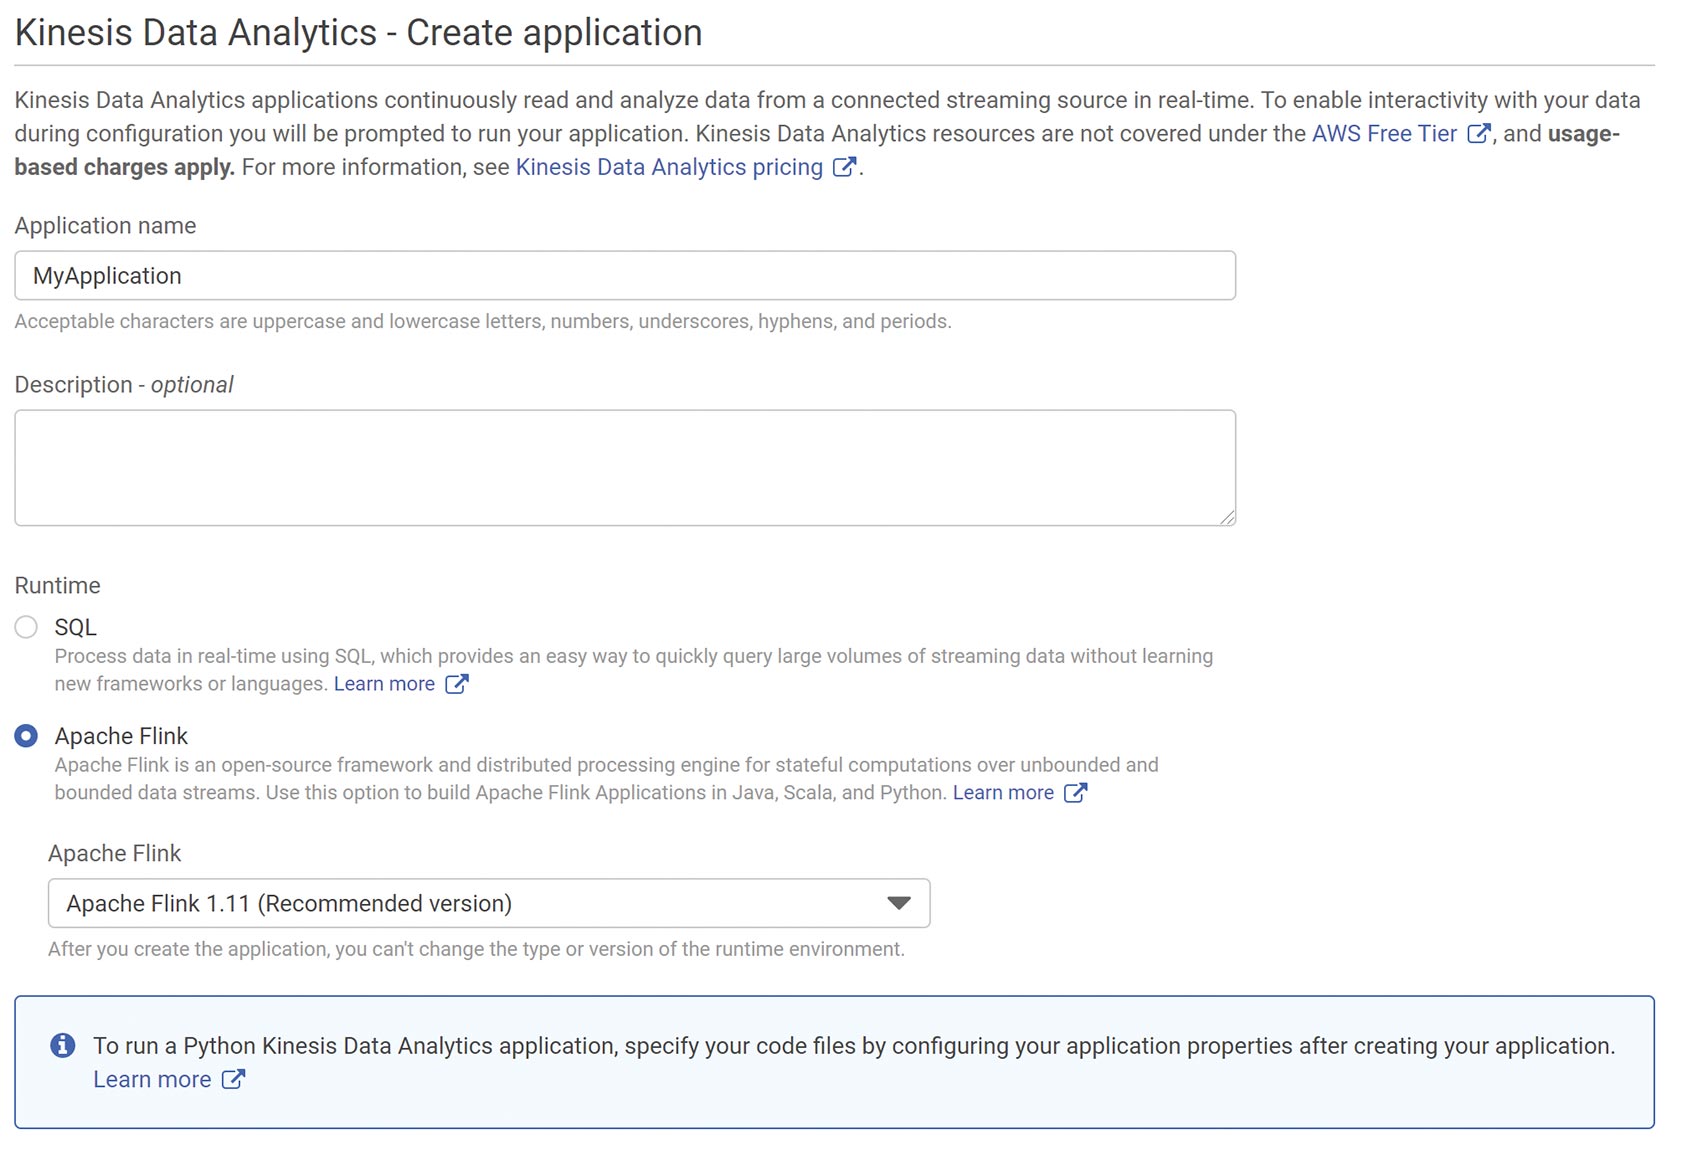 Abb. 1: Über Kinesis Data Analytics lassen sich Anwendungen mit SQL oder Apache Flink erstellen
Die meisten Unternehmen nutzen eine Kombination der drei letztgenannten Services, d. h. Amazon Kinesis Data Streams, Analytics und Firehose, wobei Amazon Kinesis Data Streams das technische Fundament darstellt. Wie ist Amazon Kinesis Data Streams also aufgebaut?
Der technische Aufbau
Bei Amazon Kinesis Data Streams (im Folgenden nur noch Amazon Kinesis genannt) besteht ein Datensatz (oder „Event“) aus einer Sequenznummer, einem Partitionsschlüssel und einem Data Blob. Der Data Blob beinhaltet die eigentlichen zu speichernden Daten als Bytes (bzw. intern Base64 serialisiert), d. h. wie bei Apache Kafka ohne Schemainformation, und darf nicht größer als 1 Mebibyte (MiB) sein.
Wie bei Message Queues üblich, werden Datensätze von Anwendungen (oder AWS Services), den sogenannten Produzenten, erzeugt und wiederum von anderen Anwendungen, den Konsumenten, der Reihe nach konsumiert. Dieser Prozess erfolgt asynchron. Eine Message Queue (bzw. ein Message Broker) hält die Nachrichten eine bestimmte Zeit lang für Konsumenten vor, sodass diese zeitlich vom Produzenten entkoppelt zu einem beliebigen Zeitpunkt abgerufen und verarbeitet werden können. Der Message Broker agiert somit als Puffer zwischen Produzenten und Konsumenten.
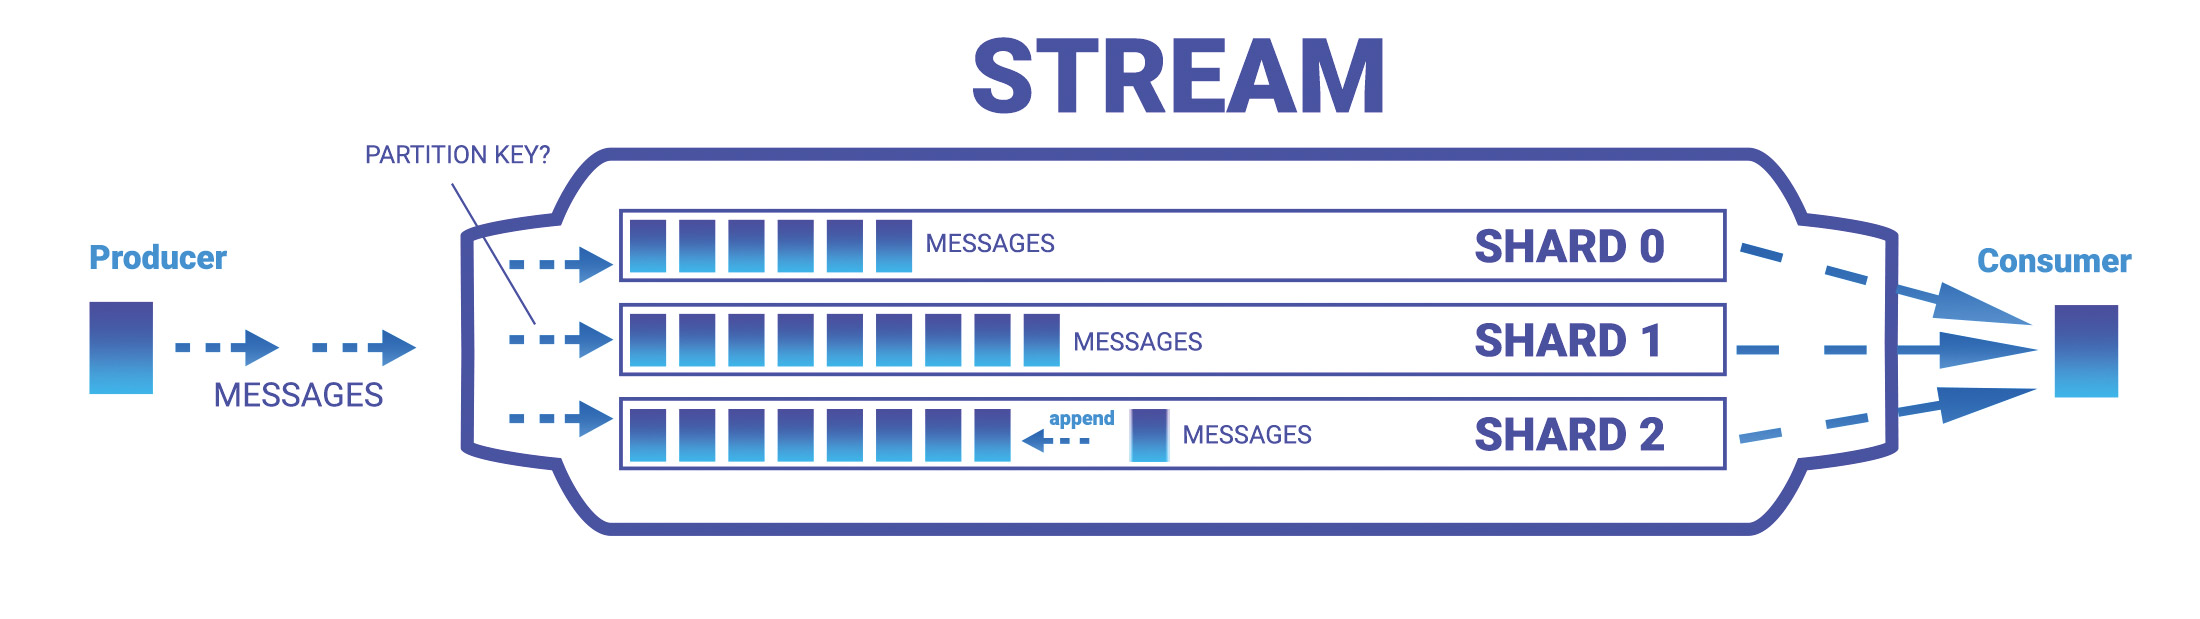 Abb. 2: Nachrichten werden innerhalb eines Streams in Kinesis Data Streams über den Partitionsschlüssel einem Shard zugeordnet
Bei der Auslieferung oder dem Schreiben von Events kann es zu Dubletten kommen. Es ist entsprechend wichtig, die vollständige Pipeline und Logik idempotent zu entwerfen.
Ähnlich wie bei Apache Kafka werden erzeugte Events bei Amazon Kinesis ebenfalls unveränderlich als Sequenz in zeitlicher Reihenfolge (append-only) gespeichert. Während eine solche Sequenz bei Apache Kafka als Topic bezeichnet wird, spricht man bei Amazon Kinesis einfach von einem Stream. Ein Stream wird in einzelne Shards unterteilt, die eine horizontale Skalierung ermöglichen. Anders als Partitionen bei Apache Kafka sind Shards dabei deutlich flexibler: In Verbindung z. B. mit den Amazon Kinesis Scaling Utilities lassen sich neue Shards bei stärkerer Last automatisiert hinzufügen und bei schwächerer Last wieder entfernen („zusammenführen“, auch Resharding genannt). Da die Kosten bei Amazon Kinesis hauptsächlich auf der Anzahl von Shards basieren, lässt sich erheblich kosteneffizienter auf unterschiedliche Lastszenarien reagieren. Bei Apache Kafka ist eine solch dynamische Anpassung nicht möglich: einmal angelegt, wird man Partitionen bei Apache Kafka nicht mehr los. Das heißt, im Gegensatz zu den Shards bei Amazon Kinesis, wird das Verringern der Anzahl der Partitionen eines Topics in Apache Kafka nicht unterstützt.
Die Zuweisung von Events zu einem Shard in Amazon Kinesis erfolgt über den Partitionsschlüssel. Ein Partitionsschlüssel („Key“ eines Events) ist eine 256 Zeichen lange Unicode-Zeichenkette. Über eine MD5-Hashfunktion wird der Schlüssel schließlich automatisch einem passenden Shard zugeordnet (Abb. 2). Dieses Verhalten lässt sich überschreiben, sodass ein Event auch explizit einem Shard zugewiesen werden kann.
Die Reihenfolge wird wie bei Partitionen in Apache Kafka nur innerhalb eines Shards garantiert. Um ein Event in einem Shard eindeutig zu identifizieren, spricht man, im Gegensatz zum Offset bei Apache Kafka, von einer Sequenznummer. Diese Sequenznummer ist allerdings wegen des technischen Unterbaus von Amazon Kinesis völlig anders zusammengesetzt als das Event Offset bei Apache Kafka: Während in Apache Kafka das erste Event in einer Partition bei null beginnt und bei jedem weiteren Event um eins inkrementiert wird (also 0, 1, …, n), ist die Sequenznummer in Kinesis erheblich größer und beginnt nicht bei null. Zwischen zwei nacheinander folgenden Datensätzen kann die Sequenznummer um eine große Zahl größer sein. Um das zu verdeutlichen, hier zwei nur zehn Sekunden auseinanderliegende Sequenznummern als Beispiel:
15:03:33: 49616572585056148483474760884126200414157508034292613122
15:03:43: 49616572585056148483474760886251492005040026810620837890
Während sich bei Apache Kafka mit Hilfe des Offsets somit beispielsweise gezielt Datensätze überspringen lassen (offset + n), ist das in Amazon Kinesis nicht möglich. Zwar wird die Sequenznummer kontinuierlich inkrementiert, die Differenz zwischen zwei Sequenznummern lässt jedoch keine Aussage über die tatsächlich dazwischenliegenden Events zu. Die zwei gezeigten Sequenznummern gehören beispielsweise zu zwei aufeinanderfolgenden Datensätzen – zwischen ihnen gibt es keine weiteren.
Ein weiterer Unterschied zu Apache Kafka ist das Fehlen eines gesonderten Bereichs für eigene Metainformationen bei einem Datensatz. Amazon Kinesis kennt im Gegensatz zu Apache Kafka keine Header, über die man z. B. Schemaversionen oder eine ID des Produzenten mitgeben kann. Somit ist es nicht ungewöhnlich, die Payload eines Datensatzes in Amazon Kinesis auf oberster Ebene um diese Informationen zu ergänzen. Die eigentlichen Daten wandern dann eine Ebene tiefer. Ein JSON-Objekt könnte dann eine Liste für Header unter einem gleichnamigen Attribut und die eigentliche Payload als Data-Objekt beinhalten.
Wie schnell ist Amazon Kinesis?
Bei der Betrachtung von Echtzeit-Data-Streaming-Technologien sind entscheidende Aspekte der Datendurchsatz und die Geschwindigkeit. Amazon Kinesis macht es im Vergleich zu Apache Kafka, wo die tatsächliche (stabile) Leistung stark vom Set-up und den gewählten Einstellungen abhängt, sehr leicht, eine solide Aussage zu treffen:
Pro Shard können 1 MiB bzw. 1 000 Datensätze pro Sekunde geschrieben werden („Ingress“).
Pro Shard können 2 MiB/Sekunde gelesen werden („Egress“), d. h., alle Konsumenten teilen sich das Kontingent, oder
pro Shard können 2 MiB/Sekunde pro Konsument gelesen werden, wenn es sich um Enhanced-Fan-Out (EFO) Consumer handelt.
Bei Apache Kafka kommt es naturgemäß auf die eigene Infrastruktur und die Einstellungen bzw. den Anbieter an. Während bei den meisten Apache-Kafka-Anbietern VMs gemietet werden müssen, auf denen die einzelnen Apache Kafka Broker laufen (wodurch natürlich die Skalierbarkeit stark leidet), bietet Confluent mit der Confluent Cloud ein vergleichbares Preismodell auf Basis von Topics und Partitionen an. Dabei ist der Durchsatz pro Partition bei der Confluent Cloud für Ingress auf 5 MiB/Sekunde und für Egress auf 15 MiB/Sekunde limitiert. Der Durchsatz wird hier unter allen Konsumenten aufgeteilt. Allerdings darf der Gesamtdatendurchsatz für jeweils Egress und Ingress für den gesamten Cluster 100 MiB/Sekunde nicht übersteigen. Im Vergleich: Bei Amazon Kinesis ist das Standardkontingent auf 200 Shards pro AWS-Konto und Region begrenzt (also „pro Cluster“) – das Limit liegt also bei 400 MiB/Sekunde Egress und 200 MiB Ingress gesamt. Sollte das nicht ausreichen, lässt sich eine Erhöhung des Kontingents beantragen.
Neben der Begrenzung des Datendurchsatzes gibt es jedoch weitere Einschränkungen, die zu beachten sind: So sind zum Beispiel verschiedene API-Aufrufe in Amazon Kinesis auf eine gewisse Anzahl pro Sekunde beschränkt. Das gilt auch für den API-Aufruf von GetRecords, der die eigentlichen Datensätze eines Shards zurückliefert. Im Abschnitt „Fallstricke aus der Praxis“ gehe ich weiter auf die daraus resultierenden Eigenarten ein.
Ein Vergleich mit einem selbstbetriebenen Apache-Kafka-Cluster (z. B. in Form von VMs) würde den Umfang des Artikels sprengen. Um einen stabilen Betrieb bei höherem Datendurchsatz zu gewährleisten, ist einiges an Tuning der Einstellungen notwendig. Nicht ohne Grund berechnet sich die Total Cost of Ownership (TCO) eines eigenen Apache-Kafka-Clusters nicht nur nach den Infrastrukturkosten, sondern auch nach Personentagen.










