Wie können Entwickler:innen mit Docker und Kubernetes PHP-Anwendungen selbst bereitstellen? Mit dieser Frage befinden wir uns im Grenzbereich zwischen Entwicklung und DevOps. Und das ist genau so, wie es in der modernen Entwicklungswelt sein sollte.
Wie implementieren und skalieren wir heutzutage PHP-Anwendungen? Cloud-Implementierungen werden heute zum Standard, aber können wir weiterhin auf ähnliche Weise arbeiten wie mit Bare-Metal-Servern?
PHP trifft Kubernetes: Herausforderungen beim Deployment von Webanwendungen
Zunächst einmal läuft das Deployment permanent auf einem Webserver. Hochgeladene Webanwendungen erhalten durchgehend eine große Menge Datenverkehr und eine Anwendung muss während des Deployments ohne Unterbrechung weiterhin Dienste für Endkunden bereitstellen. Eine weitere Herausforderung hat mit der Versionierung der Anwendung zu tun. Bei Webanwendungen ist es normalerweise schwierig, korrekte Versionierungskonzepte zu verwenden, die zwei oder mehr Versionen gleichzeitig unterstützen. Natürlich können wir Blue-Green Deployment oder die Canary-Release-Technik verwenden, wenn wir eine neue Version der Anwendung in einem Subset unserer Infrastruktur bereitstellen und das Traffic Routing zwischen zwei Versionen auf dem Balancer einrichten. Aber Kubernetes ist ein Werkzeug, das diese Funktion schon „out of the box“ mitbringt.
Webanwendungen beruhen oft auf verschiedenen States: Konfigurationen, Umgebungsvariablen, Softwareversionen, Treiber und Hardware-Set-up. Das blockiert die Fähigkeit, sie schnell und einfach zu skalieren. Klassische Bare-Metal-Set-ups erfordern manchmal nicht nur die gleiche Software, die auf den gleichen Betriebssystemen läuft, sondern oft auch ähnliche Hardware, um eine erfolgreiche Ausführung sicherzustellen. Und genau hier kommt die Anwendungscontainerisierung ins Spiel, die dabei hilft, eine stateless isolierte Webanwendung (Abb. 1) zu erstellen.
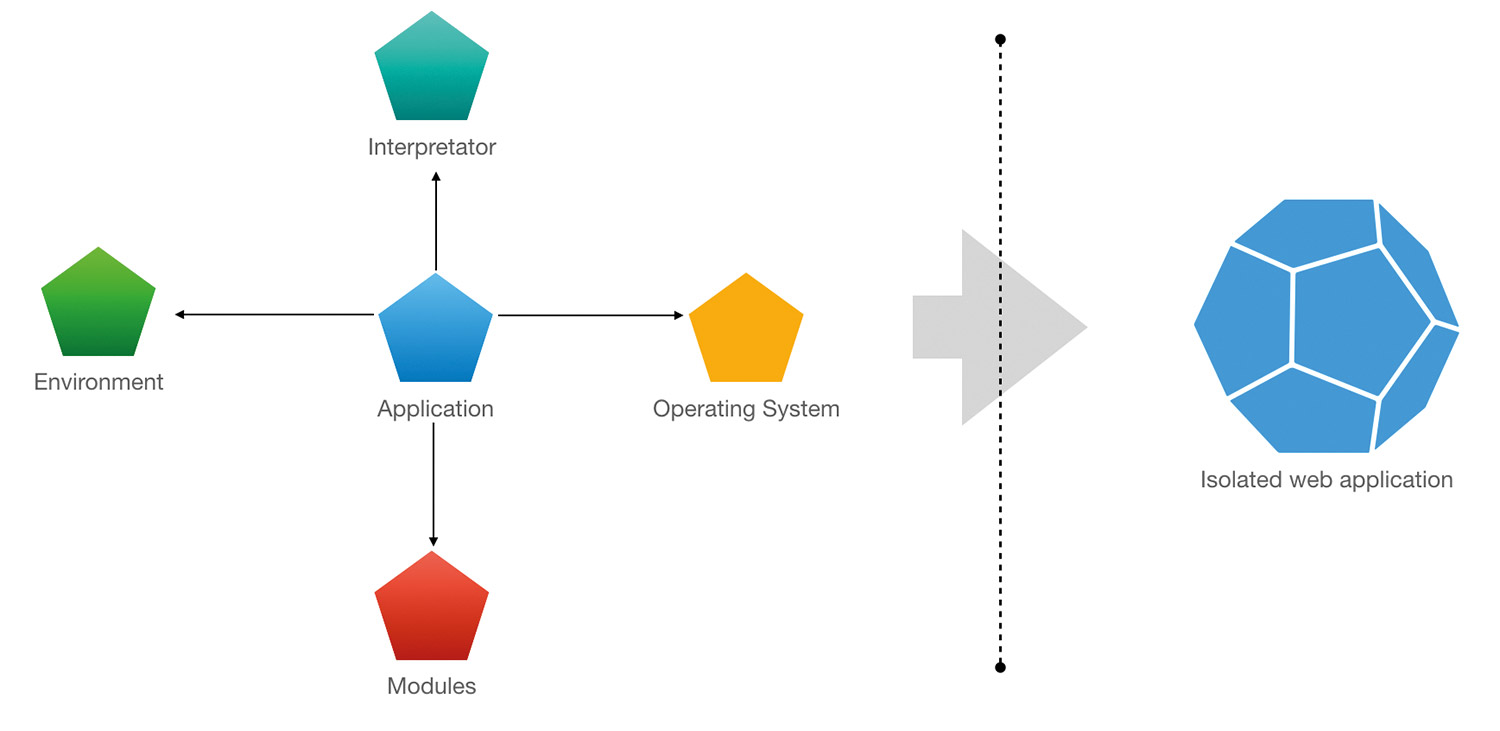
Abb. 1: Erstellung einer isolierten Webanwendung
Anstatt den State und die Dependencies zu verwalten, können wir sie in die Anwendung aufnehmen und isolieren (Abb. 2). Alles, zu dem Dependencies aus einer Anwendung heraus bestehen, einschließlich dem Betriebssystem, installierter Module und Bibliotheken sowie Umgebungseinstellungen, kann in eine einzige isolierte Anwendung gepackt werden. Sie lässt sich leicht skalieren, weil wir so viele isolierte Anwendungen ausführen können, wie wir brauchen, ohne uns um deren State und Dependencies kümmern zu müssen.
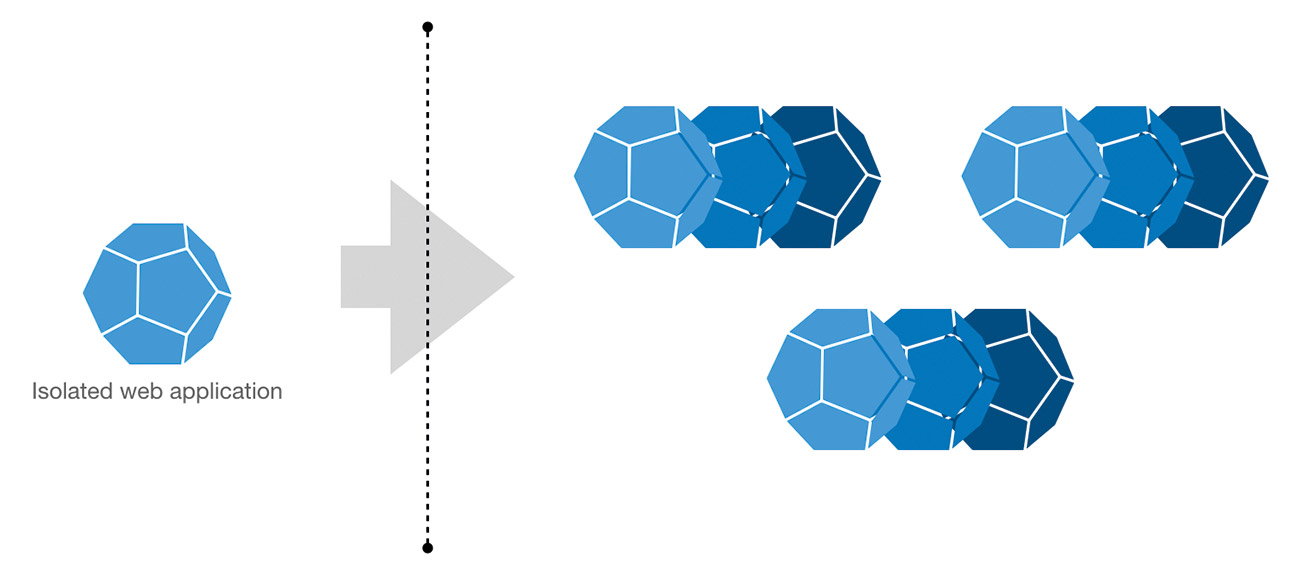
Abb. 2: Eine isolierte Webanwendung
Das sieht simpel und kompliziert zugleich aus. Bei physischen Servern haben wir das Gefühl, sie zu kontrollieren. Wenn etwas schiefläuft, können wir sie jederzeit neu starten und von vorne anfangen. Bei Containern ist das anders – wir können sie nicht anfassen, wir sollten uns nicht einmal in den Container einloggen, um den aktuellen Status zu prüfen, wenn wir eine Stateless-Anwendung betreiben. Wie also können wir Dutzende von Containern verwalten, auf denen unsere Anwendung läuft, ohne sofort ein Desaster auszulösen? Spezielle Tools namens Orchestrators kommen uns hier zu Hilfe. Orchestrators können containerisierte Anwendungen automatisch verwalten, skalieren und warten. Ich habe mit verschiedenen davon Erfahrungen gesammelt. Zunächst begann ich, meine Container mit Docker Compose zu organisieren. Das ist ein simples Tool, das es erlaubt, eine einzige Konfigurationsdatei zu erstellen, in der alles steht, was wir brauchen, um unsere Anwendung auszuführen. Docker Compose ist ein sehr gutes Tool für lokale Entwicklung. Ein weiteres Tool aus der Docker-Familie namens Docker Swarm ist sehr mächtig und erlaubt das Skalieren von Webanwendungen zwischen verschiedenen Servern, was Docker Compose an seine Grenzen bringt. Eines der praktischsten und beliebtesten Tools ist heutzutage Kubernetes. Es ist ein Open-Source-Projekt, das ursprünglich von Google, einer Firma, die effiziente Infrastrukturtools mitunter am meisten benötigt, an die Community gespendet wurde. Kubernetes bringt einige wichtige Features mit, darunter die folgenden:
Automatisierte Roll-outs und Roll-backs: Es ist einfach, einen Canary-Test während des Deployments zu erstellen, indem ein kleiner Teil des Traffics zur neuen Version umgeleitet wird. Genauso einfach sollte es sein, den kompletten Traffic zur alten Version zurückzuleiten.
Horizontale Skalierung: Kubernetes verwaltet die Anzahl der Repliken basierend auf der vorhandenen Konfiguration und den vorhandenen Limits.
Service Discovery und Load Balancing: Kubernetes bietet verschiedene Schemes, um Services freizulegen.
Selbstheilend: Kubernetes stellt sicher, dass der Applikationscluster immer im optimalen Zustand läuft.
Speicherorchestrierung: Kubernetes mountet automatisch das gewählte Speichersystem, sei es lokaler Speicher, ein öffentlicher Anbieter oder Netzwerkspeicher wie etwa NFS.
Secret- und Konfigurationsverwaltung: Kubernetes bietet die Möglichkeit, Secrets und Konfigurationen zu deployen und zu aktualisieren, ohne das Image neu zu bauen und ohne die Secrets außerhalb der Anwendung freizulegen.
Ressourcenmanagement für Container: Kubernetes bietet benötigte Ressourcen für die Applikation und begrenzt die verfügbare Menge, um einen angemessenen Ressourcenverbrauch zu gewährleisten.
Allerdings gibt es auch Dinge, die Kubernetes nicht tun soll. Zunächst einmal soll es Quellcode nicht deployen und es baut auch nicht die Anwendung. Dafür sollten andere Tools wie Jenkins zuständig sein. Auch bietet Kubernetes keine Application Level Services wie Datenbanken, Caches und Middleware als Built-in Services. Natürlich ist es möglich, Services als Teil des Kubernetes-Clusters zu betreiben, aber das ist nichts, was Kubernetes von sich aus mitbringt.
Kommen wir nun zur wichtigen Frage, ob Kubernetes ein geeignetes Tool für PHP-Anwendungen ist. Grundsätzlich sollte eine Anwendung, die in einem Container laufen kann, großartig für Kubernetes geeignet sein. Moderne PHP-Anwendungen können einfach containerisiert und somit auch mit Kubernetes deployt werden (Abb. 3).
Abb. 3: PHP trifft Kubernetes
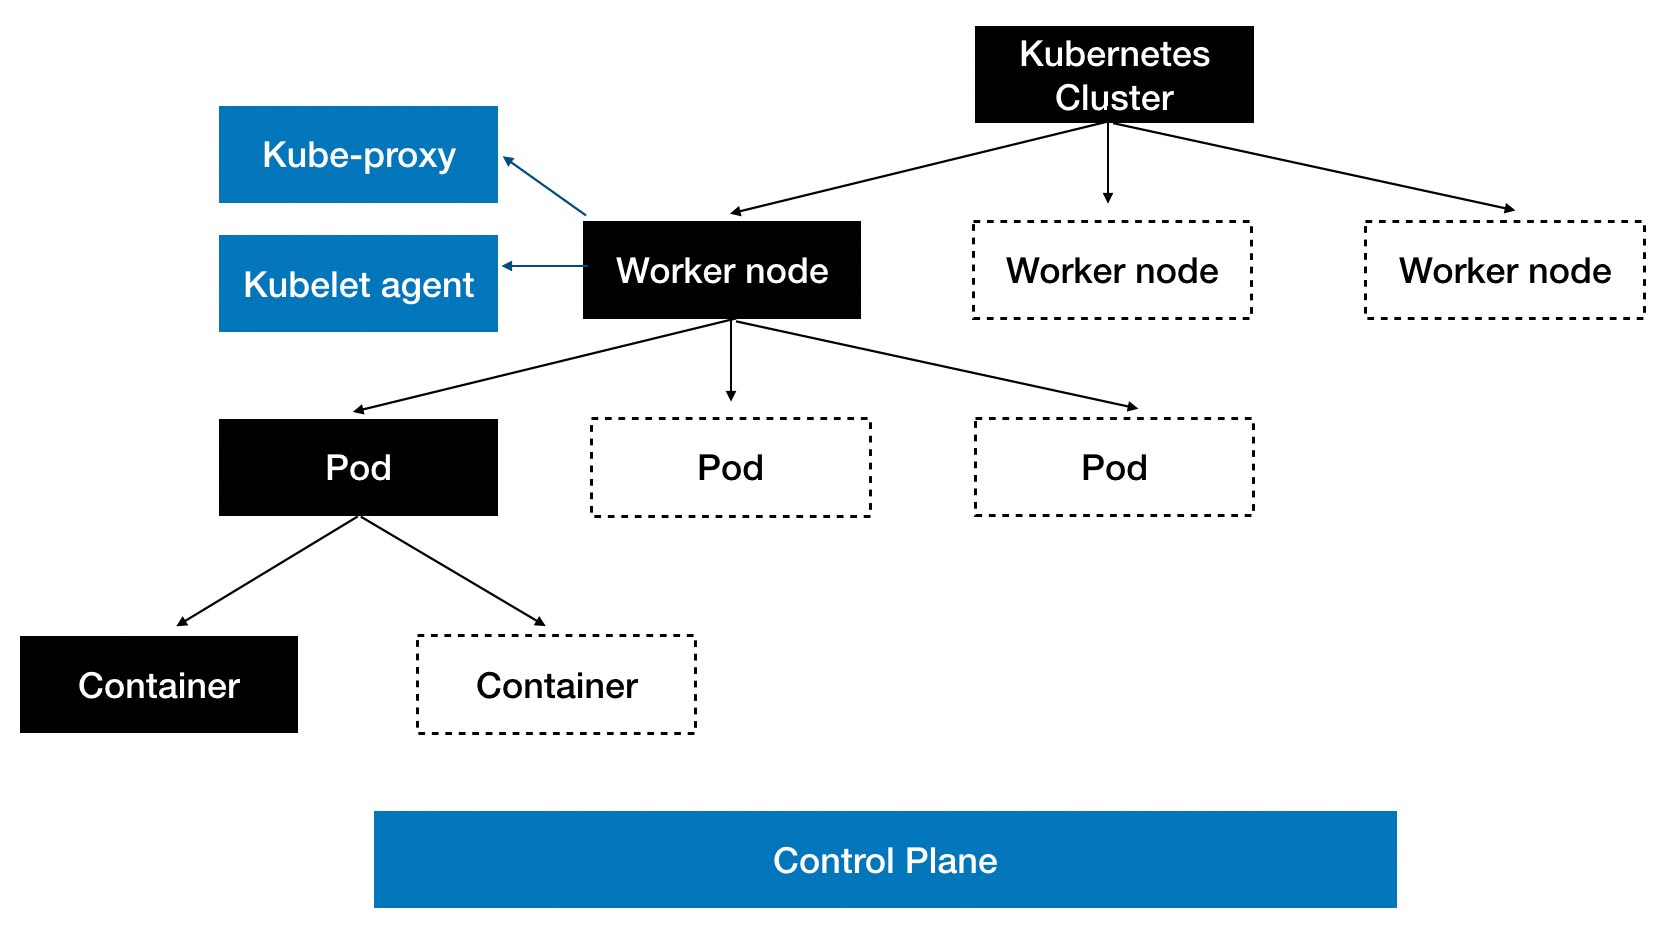
Abb. 4: Kubernetes-Cluster
Kubernetes betreibt Anwendungen auf sogenannten Kubernetes-Clustern. Sie bestehen aus einem Set von Nodes, auf denen die containerisierte Anwendung läuft. Kubernetes-Cluster erlauben Containern, auf multiplen Maschinen und Umgebungen zu laufen: virtuell, physisch, Cloud-basiert und On-Premises. Wie man in Abbildung 4 sieht, kann der Kubernetes-Cluster einen oder mehrere Worker Nodes haben. Jeder Node kann einen oder mehrere Pods betreiben und jeder Pod wiederum kann einen oder mehrere Container mit der oder für die Anwendung betreiben. Es gibt auch unterstützende Komponenten im Cluster wie etwa kube-apiserver, kube-scheduler, kube-controller-manager und viele mehr, die Teil der sogenannten Control Plane sind. Sie spielen eine wichtige Rolle dabei, globale Entscheidungen über das Cluster zu treffen, z. B. das Planen von Ressourcen und Deployments oder die Reaktion auf das Starten/Stoppen von Cluster-Events. Hier geschieht die ganze Magie des Clustermanagements.
Auf jedem Node laufen kubelet, der primäre Node Agent, der den Node auf dem Kubernetes-API-Server registrieren kann, und kube-proxy, das die Netzwerkregeln auf Nodes anwendet. API Server ist eine sehr wichtige Komponente, die es uns erlaubt, mit dem Cluster zu kommunizieren, und die ein RESTful API zur Verwaltung von Kubernetes bietet. Das ist ein sehr mächtiges Werkzeug, das die Abfrage und Manipulation des Status der Objekte im Cluster erlaubt. Obwohl das volle API via REST Calls direkt angesprochen werden kann, werden die meisten Operationen durch das kubectl CLI oder andere Kommandozeilenwerkzeuge wie kubeadm durchgeführt, die ihrerseits das API verwenden (Abb. 5).
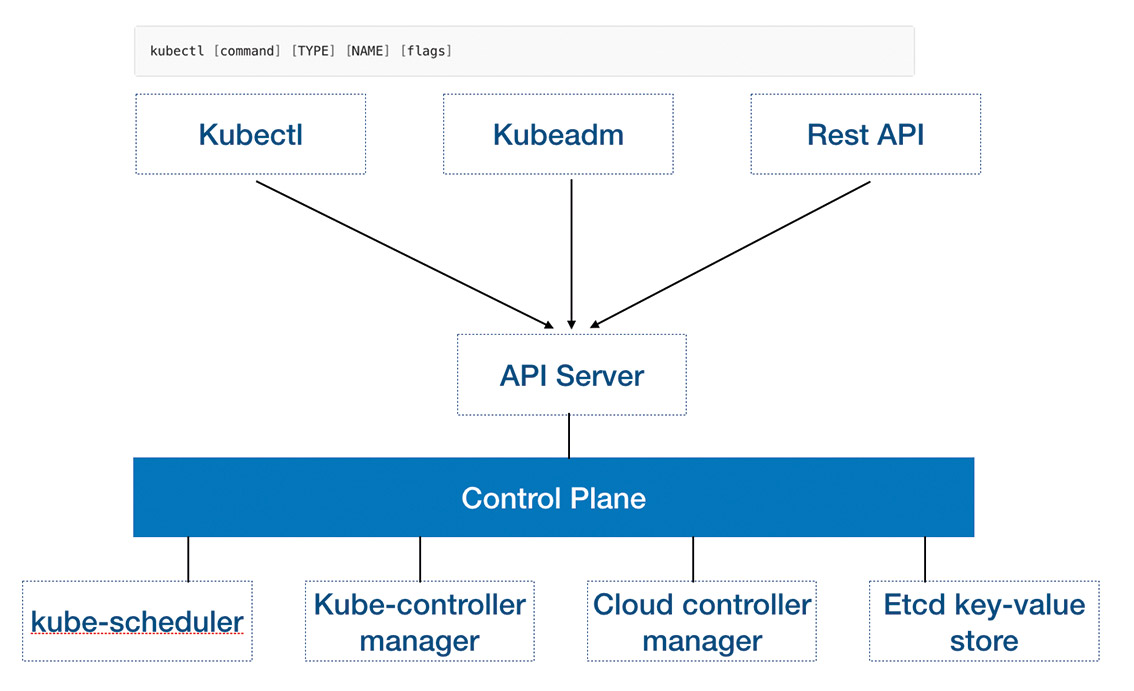
Abb. 5: Zugriff auf das API
Kubernetes-Objekte
Kubernetes verwendet Objekte als persistente Entitäten im System, um den Status des Clusters zu repräsentieren. Typischerweise beschreibt ein Kubernetes-Objekt genau, was wo läuft, welche Ressourcen verfügbar sind und welche Neustart-, Upgrade- und Fehlertoleranzrichtlinien für die containerisierte Anwendung verwendet werden.
Durch das Erstellen und Bereitstellen eines Kubernetes-Objekts sagen wir dem Kubernetes-System, wie wir uns den Workload unseres Clusters vorstellen und was sein gewünschter Zustand ist. Ein Objekt hat einen type, z. B. _DaemonSet, Deployment _oder Service sowie metadata, inklusive Name, Annotationen oder Labels, und _spec _mit dem gewünschten Status, z. B. Container-Image, Anzahl der Repliken, Umgebungsvariablen oder Volumes. Um das besser zu verstehen, sollten wir uns ein Beispielprojekt anschauen, das ich vorbereitet habe. Das Projekt ist eine sehr simple PHP-Anwendung, die nur eine Datei enthält, die eine simple Zeile mit dem aktuellen Datum, der aktuellen Zeit und einem Reminder, dass es an der Zeit ist, etwas Kaffee zu trinken, ausgibt:
<?php
header("Content-Type: application/json");
echo json_encode([date("c") => "Time to drink some coffee"]);
Natürlich ist das ein Dummyprojekt ohne irgendwelche Businesslogik dahinter. Allerdings handelt es sich nur um ein Beispiel, stattdessen könnte es auch eine PHP-Anwendung jeglicher Art von Komplexität sein. Um diese kleine Anwendung auszuführen, müssen wir sie containerisieren. Im Folgenden sehen Sie ein simples Dockerfile, eine Konfigurationsdatei, die beschreibt, welche Befehle ausgeführt werden sollen, um das Image dafür zu erstellen:
FROM php:7.4-fpm
COPY . /usr/src/myapp
WORKDIR /usr/src/myapp
CMD [ "php-fpm"]
Dadurch wird eine isolierte Infrastruktur gesetzt, die benötigt wird, um die Anwendung auszuführen. Da wir eine Webanwendung haben, benötigen wir möglicherweise zusätzlich einen zweiten Container mit einem nginx-Webserver, der der PHP-Anwendung für Webtraffic dienen wird. Nehmen wir als Basis ein Default-Image von Docker Hub, einem nativen Repository, das viele offizielle Images enthält, die zur Verwendung bereitstehen.
Wir erstellen unser erstes Kubernetes-Objekt
Um zu den Kubernetes-Objekten zurückzukehren, können wir nun versuchen, unser erstes simples Objekt mit dem Typ _Deployment _zu erstellen (Listing 1).
Listing 1
apiVersion: apps/v1
kind: Deployment
metadata:
  name: demo-php
  labels:
    app: demo
spec:
  selector:
    matchLabels:
      app: demo
  replicas: 3
  template:
    metadata:
      labels:
        app: demo
    spec:
      containers:
        - name: demo-php
          image: demo-php:latest
          ports:
            - containerPort: 9000
        - name: demo-nginx
          image: demo-nginx:latest
          ports:
            - containerPort: 80
In diesem Objekt definieren wir als Erstes die API-Version (v1), Art des Objekts (Deployment) und Metadaten mit dem Namen der Anwendung. Aber der wichtigste Teil ist der spec-Bereich, der die gesamte Menge an Repliken beschreibt, aktuell auf drei eingestellt, und der Container, inklusive der PHP-Anwendung und eines nginx-Webservers. Objekte können imperativ verwaltet werden, indem Operationen mit Hilfe von kubectl-Befehlen direkt auf Liveobjekte im Cluster angewendet werden:
kubectl create deployment nginx --image nginx
Oder wir verwenden den kubectl-Befehl, um die Operation zu spezifizieren (create, replace etc.), optionale Flags und zumindest einen Dateinamen einzugeben. Die spezifizierte Datei muss eine volle Definition des Objekts im YAML- oder JSON-Format enthalten.
kubectl create -f nginx.yaml
kubectl delete -f nginx.yaml -f redis.yaml
PHP trifft Kubernetes: Pod-Verwaltung mit Workload-Ressourcen
Um einen Schritt zurückzugehen, ist ein Pod die kleinste deploybare Recheneinheit, die man in Kubernetes erstellen und verwalten kann. Allerdings müssen wir nicht jeden Pod direkt verwalten. Stattdessen verwenden wir Workload-Ressourcen (Abb. 6), die ein Set von Pods für uns verwalten. Diese Ressourcen konfigurieren Controller, die sicherstellen, dass die richtige Menge an richtigen Pods läuft, um dem spezifizierten State zu entsprechen.
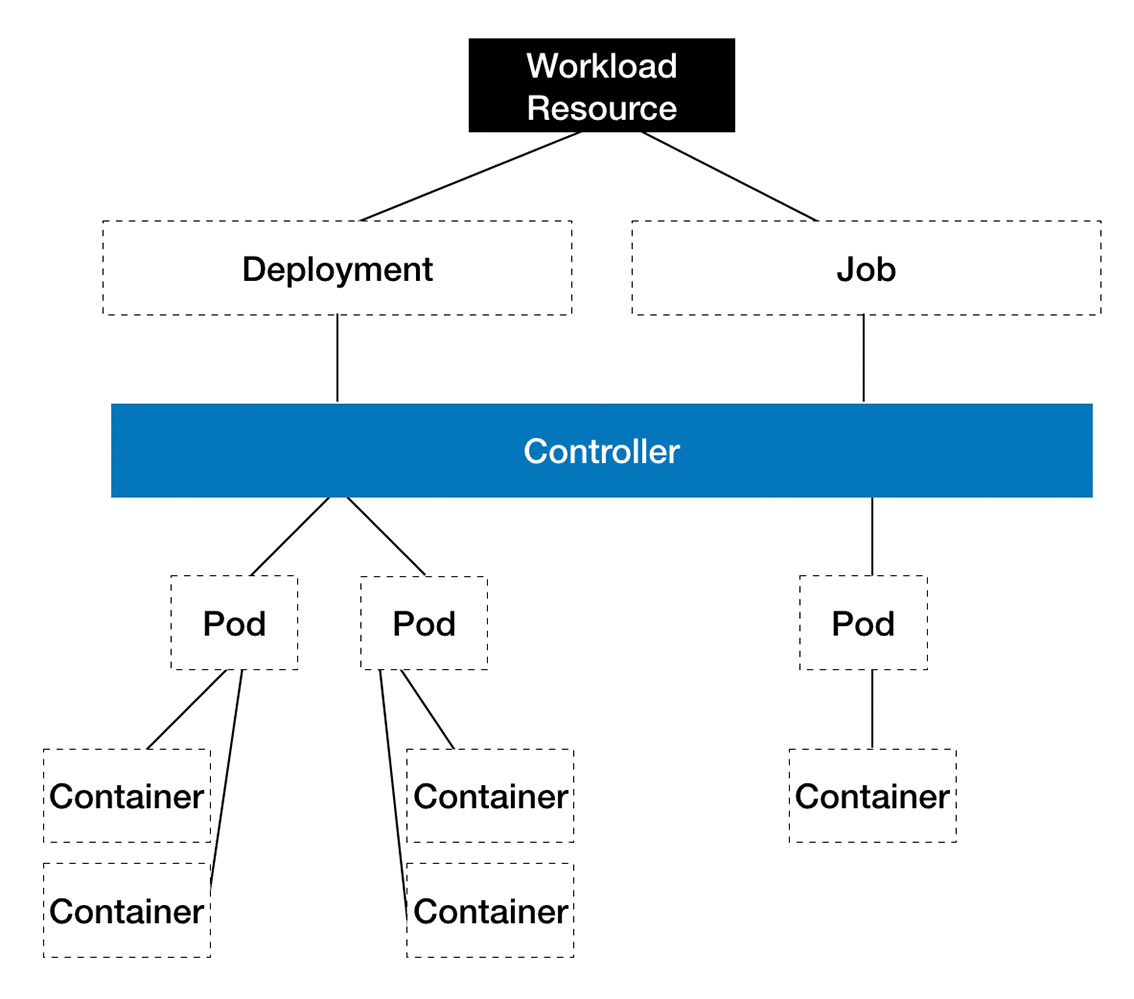
Abb. 6: Workload-Ressourcen
Workload-Ressourcen können unter anderem Deployment, ReplicaSet, Job oder Cronjob sein. Wenn wir dieses Wissen auf das in Listing 1 beschriebene Objekt anwenden, verstehen wir es ein wenig besser. Alles, was im ersten spec-Abschnitt steht, beschreibt ein ReplicaSet von drei Repliken, die innerhalb des Kubernetes-Clusters erstellt werden sollen. Ein weiterer spec-Abschnitt innerhalb des Template-Bereichs beschreibt, welche Container in jedem Pod enthalten sein sollen. Auf die gleiche Weise kann z. B. CronJob, das wir zuvor gesetzt haben, als Linux Schedule beschrieben werden. Kubernetes kann das Scheduling autonom verwalten (Listing 2).
Listing 2
apiVersion: batch/v1beta1
kind: CronJob
metadata:
  name: demo-php
spec:
  Schedule: "*/1 * * * *"
  jobTemplate:
    spec:
      containers:
        - name: demo-php
          image: demo-php:latest
          command: ["/bin/sh"]
          args: ["-c", "exec 3<>/tmp/stdout; cat <&3 >&2 & exec php index.php >/tmp/stdout 2>&1"]
Um unsere Anwendung auf automatisierte Weise skalieren zu können, müssen wir das Deployment-Objekt um eine Beschreibung der verfügbaren Ressourcen erweitern. In unserer Deployment Config können wir die Ressourcen request und limits (Listing 5) festlegen. Der Request-Wert wird vom Scheduler verwendet, um zu entscheiden, auf welchem Node jeder Pod platziert werden soll. Wenn wir zum Beispiel drei Nodes zur Verfügung haben und auf zweien davon Ressourcen fest geplant sind, indem dort bereits Pods laufen, wird der Scheduler den Request-Wert nutzen, um zu verstehen, dass der nächste Pod auf dem dritten Node platziert werden soll (Abb. 7).
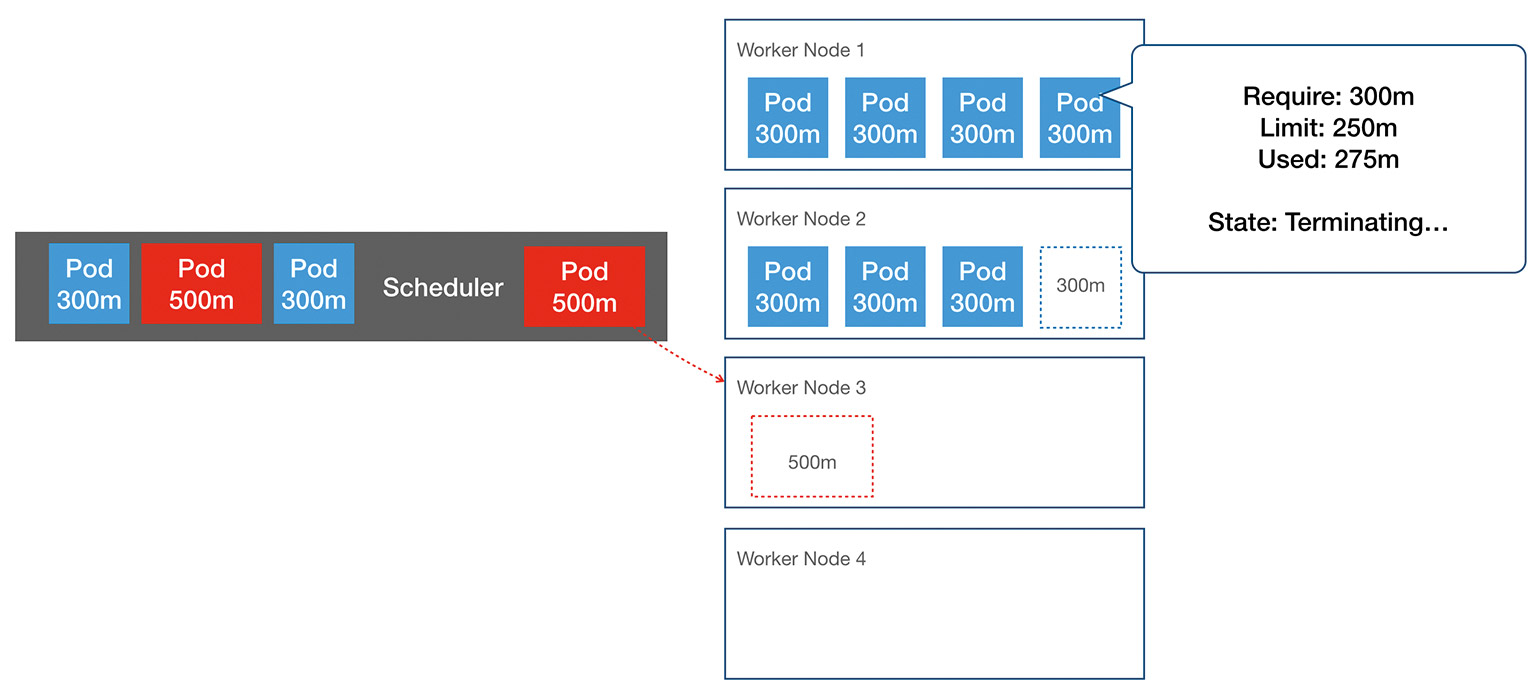
Abb. 7: Pod-Zuweisung auf Nodes
Der limit-Wert zeigt, wie viele der Ressourcen der Container verwenden darf. Wenn der Container mehr als ein limit erreicht hat, wird er von Kubernetes terminiert. Das ist z. B. dann sehr hilfreich, wenn PHP-Anwendungen ohne korrekte Garbage Collection eine extensive Menge an Memory verbrauchen. Fall Sie sich wundern sollten: In der Konfiguration in Listing 3 ist die cpu-Ressource in den Units der Kubernetes-CPU definiert, wobei 1 CPU äquivalent zu 1 vCPU oder Kern bei Cloud-Anbietern ist. Zum Beispiel sind 250m, was als „Milli-CPUs“ gelesen werden kann, das Gleiche wie 0.25 CPU.
Listing 3
containers:
  - name: demo-php
    image: demo-php:latest
    imagePullPolicy: Never
    resources:
      limits:
        cpu: 150m
      requests:
        cpu: 100m
        memory: 100Mi
    ports:
      - containerPort: 9000
Automatische Skalierung in Kubernetes: Horizontal Pod Autoscaler
Ressourcenbegrenzung hilft dem Scheduler beim automatischen Verwalten der Container. Um die Anwendung komplett automatisch zu skalieren, hat Kubernetes ein relativ neues Feature namens Horizontal Pod Autoscaler (Abb. 8). Es skaliert automatisch die Anzahl der Pods im Deployment, für gewöhnlich basierend auf der CPU-Nutzung. Der Controller-Manager fragt periodisch den Ressourcenverbrauch ab und passt die Anzahl der Repliken im Deployment an, um die beobachtete durchschnittliche CPU-Nutzung an das vom User spezifizierte Ziel anzugleichen.
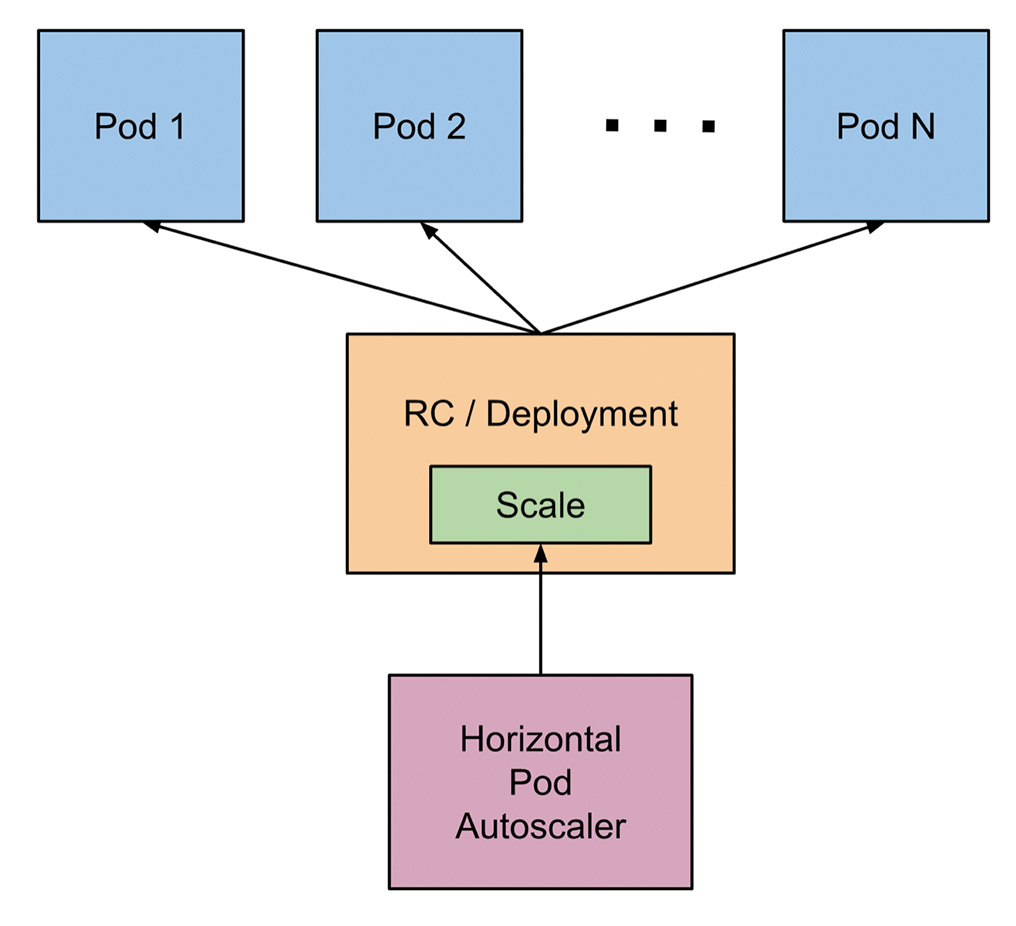
Abb. 8: Horizontal Pod Autoscaler
In Listing 4 definieren wir eine neue Ressource mit kind HorizontalPodAutoscaler. Hierbei ist zu beachten, dass wir apiVersion: autoscaling/v1 nutzen. Im spec dieser Ressource definieren wir minReplicas und maxReplicas. Und wir definieren auch _targetCPUUtilisationPercentage _auf 50. Das bedeutet, dass der Autoscaler die Anzahl der Repliken von 1 bis 10 variiert, während er versucht, die gesamte durchschnittliche CPU-Nutzung auf 50 Prozent zu halten. Wenn die CPU-Nutzung ansteigt, wird einfach eine neue Replik erstellt. Wenn die CPU-Nutzung sinkt, skaliert der Autoscaler eine Anwendung herunter, indem nicht benötigte Repliken terminiert werden.
Listing 4
apiVersion: autoscaling/v1
kind: HorizontalPodAutoscaler
metadata:
  name: demo-php
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: php-apache
  minReplicas: 1
  maxReplicas: 10
  targetCPUUtilizationPercentage: 50
Um schließlich unsere simple PHP-Anwendung freizulegen, um sie für den Endkunden bereitzustellen, müssen wir eine neue Workload-Ressource namens Service ankündigen. Sie ist eine Abstraktion, die ein Set von Pods definiert, sowie eine Policy, wie auf sie zugegriffen werden kann. Service ist demnach ein REST-Objekt, ähnlich wie ein Pod. Das Set von Pods, das das Ziel eines Service ist, wird für gewöhnlich durch einen selector festgelegt (Listing 5).
Listing 5
apiVersion: v1
kind: Service
metadata:
  name: test-app
  labels:
    app: nginx
spec:
  ports:
    - port: 80
      protocol: TCP
  selector:
    app: demo
Das Deployment mit Replica Set und Service reicht aus, eine simple PHP-Anwendung durch die Anwendung von Objektkonfigurationsdateien zu einem Cluster zu deployen. Das kann auf einfache Weise per kubectl-Kommandozeilenwerkzeug durchgeführt werden:
docker build . -t demo-php
docker build ./nginx -t demo-nginx
kubectl apply -f deployment.yaml
kubectl apply -f service.yaml
PHP in einem Kubernetes-Cluster: Rückkehr in den Hafen
Das Verwalten von PHP-Anwendungen in einem Kubernetes-Cluster ist simpel und effektiv. Ein wichtiger Vorteil ist, dass wir Anwendungen zusammen mit der Clusterkonfiguration lokal entwickeln können und diese Konfiguration später für das Deployment einer Anwendung in die Cloud oder sogar On-Premises nutzen können. Dadurch rückt lokales Deployment näher an die Produktionsumgebung.
Als letzten Punkt sollte man beachten, dass es beim lokalen Deployment von Kubernetes verschiedene Wege gibt. Zum Beispiel erlaubt eine Docker-Desktopanwendung die Ausführung eines lokalen Kubernetes-Clusters. Meine Empfehlung ist jedoch, Minikube zu nutzen – eine Anwendung, die einen einfachen Weg bietet, Kubernetes-Cluster lokal zu erstellen. Die einzige Voraussetzung ist das zuvor installierte Docker. Nachdem man Minikube geöffnet hat, startet es lokale ready-to-use Kubernetes-Cluster mit ihrem eigenen minikube-Kontext, der dafür sorgt, dass es kein Überschneiden mit Remoteclustern gibt, die man möglicherweise mit lokalem kubectl verwaltet. Das alles bietet Entwicklern die einzigartige Erfahrung, produktionsfertige Webanwendungen von Entwickler- und Operationssseite her zu erstellen. Auf meiner GitHub-Seite können Sie an einer Demoanwendung lernen und mir Fragen direkt per E-Mail zukommen lassen, falls etwas unklar sein sollte.
Danke fürs Lesen und viel Spaß mit Kubernetes!

In ihrer Einführung in Kubernetes vermitteln Thomas Schwärzl und Dr. Andreas Hess die Grundlagen von Docker und Kubernetes. In vielen Beispielen erhältst du ein Grundverständnis der Container-Orchestrierung mit Kubernetes.











