Nur das Beste für Container
In den vergangenen Jahren haben wir unsere Anwendungen in Container verpackt, um sie zu isolieren und leicht auslieferbar zu machen. Nun kämpfen wir damit, Anwendungen mit persistenten Daten in Containern zu betreiben, um sie fehlertoleranter und skalierbarer zu machen. Daher betreiben wir Datenbanken meistens in separaten Clustern, weil es noch relativ schwer ist, sie sinnvoll in Containern zu orchestrieren. Das bedeutet allerdings, dass wir unsere gesamte Infrastruktur nicht optimal ausnutzen und Skalierungseffekte zwischen zustandslosen und zustandsbehafteten Anwendungen verschenken. Aber was bedeutet es eigentlich, eine Datenbank in einen Container zu stecken?
Im vorigen Teil haben wir uns mit verschiedenen Arten von Speicher, Clustern und Back-ups beschäftigt. Wir haben diskutiert, wie wir Technologien aus diesen drei Bereichen sinnvoll kombinieren können, um eine möglichst robuste und fehlertolerante, aber trotzdem performante Datenbank zu betreiben. In diesem Teil wollen wir uns nun einige Aspekte genauer anschauen und ihre Performanz vergleichen, um zu sehen, wie stark sich die beschriebenen Eigenarten wirklich in unseren Umgebungen auswirken. Weiterhin wollen wir diskutieren, welche Auswirkungen Container auf die Nutzung von CPU beziehungsweise Arbeitsspeicher haben, und über was wir uns noch Gedanken machen sollten, wenn wir Container in Produktion bewegen wollen.
Genug Palaver, her mit den Zahlen!
Warum es sinnvoll erscheint, Overlay 2 im Vergleich zu Overlay 1 zu verwenden, haben wir bereits zuvor erörtert. Das Schöne ist, dass wir Docker mit dem Storage-Treiber konfigurieren können, den wir gerne hätten, und auf diese Weise wunderbar die Performanz miteinander vergleichen können. Welcher Storage-Treiber aktuell konfiguriert ist, sieht man übrigens, wenn man docker info ausführt.
Unser Testkandidat ist ein Docker Image mit dem Namen neo-technology/overlay-pull, das die Größe von 1,17 GB hat. In Abbildung 1 sehen wir die Ergebnisse von jeweils drei Messungen, die ich mit dem Befehl time docker pull neo-technology/overlay-pull durchgeführt habe. Die Messung fand auf meinem Laptop statt, und die Images befanden sich in der Docker Registry von GCP. Es wurden immer abwechselnd die Werte von Overlay 1 und Overlay 2 gemessen und kein Netflix oder YouTube währenddessen an- oder abgeschaltet. Wir sehen also, dass wir von ungefähr zweieinhalb Minuten auf eine Minute heruntergekommen sind, allein bei einem docker pull. Die Performanz verhält sich ähnlich, wenn wir schreibende Transaktionen gegen die Datenbank durchführen, die Overlay 1 bzw. Overlay 2 verwendet.
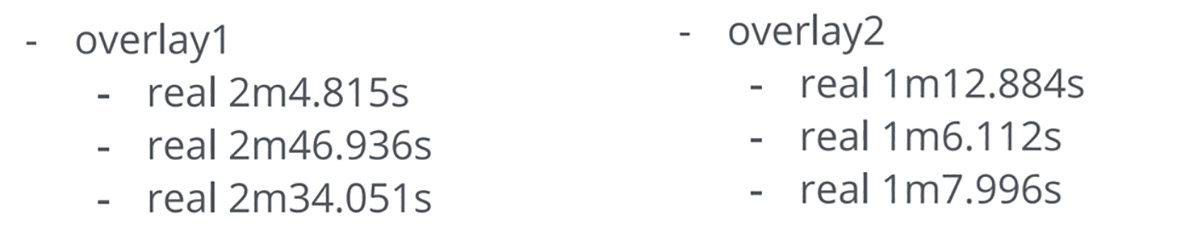 Abb. 1: Messergebnisse „time docker pull neo-technology/overlay-pull“
Cluster, lokaler Speicher und entfernter Speicher
Es macht also einen Unterschied, ob ich Overlay 1 oder Overlay 2 benutze. Aber wie verhält sich das Ganze denn nun im Vergleich zu entferntem Speicher und Clustern? Für diesen Zweck habe ich im Zuge einer Vortragsvorbereitung vor ungefähr einem Jahr eine Vergleichsmessung angefertigt.
Bei diesem Test vergleichen wir ungefähr eine halbe Million schreibende Transaktionen zum einen gegen Neo4j in einem Docker-Container, bei dem das Datenvolumen nicht gemountet wurde, aber Overlay 2 der Storage-Treiber war. Zum anderen wird gegen einen Docker-Container getestet, bei dem das Volumen gemountet wurde, da wir im letzten Teil ja diskutiert hatten, dass dies erhebliche Vorteile mit sich bringt. Wir vergleichen außerdem gegen einen Docker-Container, der sein Volumen in Blockspeicher (EBS) gemountet hat und gegen ein Cluster.
An dieser Stelle sollte ich erwähnen, dass der Vergleich nicht 100 Prozent fair beziehungsweise nicht richtig vergleichbar ist. Die drei ersten Kandidaten liefen nämlich auf AWS in Verbindung mit EC2, der Cluster hingegen lief auf der Google Cloud Platform, mit der gleichen Anzahl an CPUs und Arbeitsspeicher...











