Gemeinsam mehr erreichen
Die Verbreitung der Akronyme CQRS und DDD nimmt seit einigen Jahren stetig zu: Vor allem im Kontext von Microservices begegnet man den beiden Konzepten immer häufiger. Was steckt dahinter?
CQRS steht für Command Query Responsibility Segregation und bezeichnet die strikte Trennung der Schreib- und der Lesevorgänge einer Anwendung beziehungsweise eines API. In der klassischen Anwendungsarchitektur wird die mittlere Ebene, die typischerweise über ein API verfügt, als eine in sich geschlossene Einheit gesehen, auf die vom UI aus zugegriffen wird. CQRS schlägt stattdessen vor, die Aktionen des Benutzers ganz klar zu kategorisieren:
Auf der einen Seite stehen Commands, die eine Intention des Benutzers ausdrücken und zumeist eine Zustandsänderung innerhalb der Anwendung nach sich ziehen. Da sie die Intention ausdrücken, sollten sie nicht mit Create, Update und Delete benannt werden. Diese Verben bezeichnen nämlich technische Implikationen, nicht fachliche Absichten. In der Fachsprache tauchen üblicherweise andere, domänenspezifische Begriffe auf, die sich in den Commands entsprechend wiederfinden sollten.
Auf der anderen Seite stehen Queries, die den aktuellen Zustand der Anwendung abfragen, ihn aber nicht ändern. Queries entsprechen also reinen Lesevorgängen, wohingegen Commands das Schreiben in einer Anwendung repräsentieren.
Viel mehr als das ist CQRS zunächst einmal nicht. Es sagt insbesondere nichts über die konkrete Implementierung aus, auch nicht über die Struktur der Datenhaltung. CQRS gibt noch nicht einmal vor, wie das API strukturiert und seine Routen benannt sein sollten: Wichtig ist einzig und allein, dass das Schreiben vom Lesen getrennt wird – auf welche Art auch immer.
CQRS in einem API implementieren
Eine einfache Möglichkeit, CQRS in einem API zu implementieren, besteht darin, sich gedanklich von REST zu verabschieden und stattdessen nur noch POST und GET einzusetzen. POST steht dabei aus naheliegenden Gründen für schreibende Vorgänge (also für Commands), GET wird hingegen zum Lesen (also für Queries) verwendet. Da die Semantik wie Anlegen, Ändern oder Löschen von Dingen nun nicht mehr über das HTTP-Verb ausgedrückt wird, muss die eigentliche Aktion Bestandteil des URL werden.
Queries beziehen sich immer auf den aktuellen Stand und entsprechen vom Verb her letztlich immer dem Lesen. Bei ihnen genügt deshalb eine substantivische Beschreibung, welche Daten des Zustands gelesen werden sollen.
Bevor man beginnt, ein API zu implementieren, lohnt es sich, eine Liste der gewünschten Commands und Queries zu erstellen und zumindest für einen Moment über ihre Benennung nachzudenken. Das wiederum funktioniert natürlich nur in einem gegebenen fachlichen Kontext. Deshalb wird im weiteren Verlauf des Artikels eine einfache To-do-Listen-Anwendung als Beispiel verwendet, wie man sie beispielsweise aus dem Projekt TodoMVC [1] kennt.
Doch selbst das genügt noch nicht, um festzulegen, welche Commands und Queries man benötigt. Dafür muss nämlich zuerst noch mehr Klarheit bezüglich der tatsächlichen Funktionalität geschaffen werden. Abbildung 1 zeigt das dazu passende UI:
Der Anwender soll sich neue Aufgaben notieren können, wobei eine Aufgabe lediglich aus einer Beschreibung besteht.
Die Beschreibung einer Aufgabe soll sich auch im Nachhinein noch ändern lassen.
Aufgaben können, wenn sie erledigt wurden, vom Anwender abgehakt werden.
Das Abhaken einer Aufgabe soll sich zurücknehmen lassen. Das ist beispielsweise dann relevant, wenn eine Aufgabe fälschlicherweise oder aus Versehen abgehakt wurde.
Gelegentlich erübrigen sich Aufgaben im Lauf der Zeit auch von selbst. Sie sind zwar hinfällig, aber genau genommen nicht erledigt. Insofern wäre es falsch, sie abzuhaken. Vielmehr sollen solche Aufgaben verworfen werden können.
Zu guter Letzt soll es für den Anwender möglich sein, erledigte beziehungsweise hinfällige Aufgaben zu archivieren. Solche Aufgaben sollen dann zwar nicht gelöscht werden, über das UI aber nicht mehr sichtbar sein.
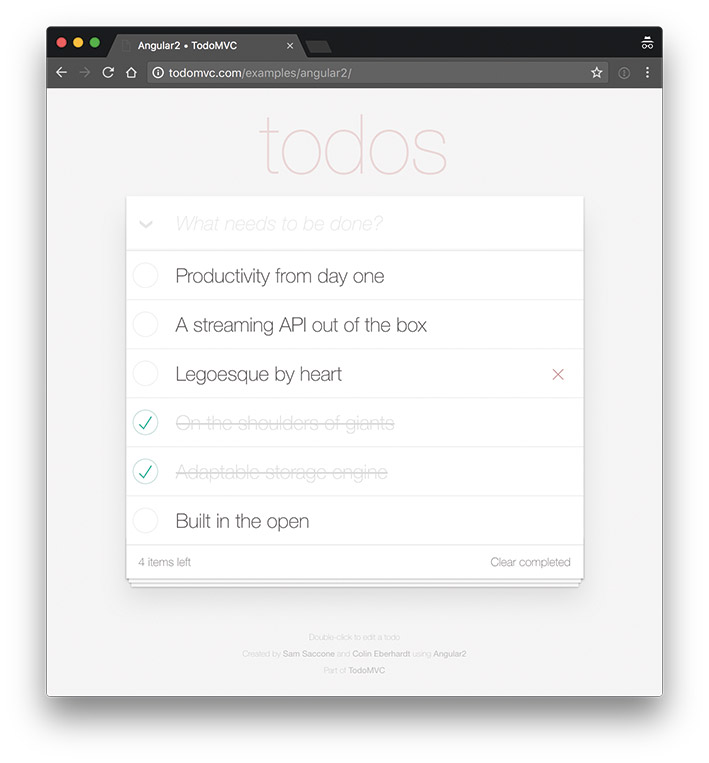 Abb. 1: UI der To-do-Anwendung
Wie bereits erwähnt empfiehlt es sich an der Stelle, nicht aus Gewohnheit auf Create, Update und Delete zu setzen, sondern Begriffe zu suchen, die auch in der Fachlichkeit enthalten sind. Das führt dazu, dass das API und die Fachlichkeit näher aneinanderrücken, was das Verständnis der Verwendern für das API wiederum verbessert: Man muss nicht eine fachliche und eine technische Sprache und das Mapping zwischen beiden lernen – es genügt, wenn man sich in der Fachsprache auskennt.
Commands und Queries definieren
Das Command zum Notieren einer neuen Aufgabe sollte also nicht Create Task heißen, denn Create ist von seiner Bedeutung her zu weit weg von „notieren“ (abgesehen davon handelt es sich bei der Anwendung um eine To-do- und nicht um eine Taskliste, weshalb auch das Wort Task unpassend ist). Deutlich besser wäre daher z. B. Note Todo.
Auch das Bearbeiten einer Aufgabe ist nicht einfach nur ein Update Todo, da Update ein Wort ist, das einen technischen Vorgang beschreibt, aber keinen fachlichen. Besser, weil inhaltlich treffender, wäre hier etwa Edit Todo. Spätestens beim Abhaken, dem Verwerfen und dem Archivieren merkt man sehr deutlich, wie unpassend Update und Delete sind: Während das eine viel zu unspezifisch ist, trifft das andere genau genommen in keinem einzigen Fall zu – schließlich sollen die verschiedenen Aktionen rückgängig gemacht werden können, und beim Archivieren ist sogar explizit gefordert, dass die Aufgabe zwar nicht mehr angezeigt, aber eben nicht gelöscht wird. Würde man sich hier mit dem klassischen Vokabular begnügen, hätte man lauter Update Todo-Commands, die man nicht voneinander unterscheiden könnte und die deshalb ziemlich beliebig wären.
Passender wären zum Beispiel Tick Off Todo, Resume Todo und Discard Todo zum Abhaken, Fortsetzen und Verwerfen...











