
Die perfekte Ergänzung?
Machine Learning (ML) ermöglicht es Anwendungen, versteckte Erkenntnisse zu gewinnen, ohne explizit dafür programmiert worden zu sein, worauf sie bei der Erkenntnisfindung achten müssen. So können unstrukturierte Daten analysiert, Bild- und Spracherkennung verbessert und fundierte Entscheidungen getroffen werden. In diesem Artikel werden wir vor allem neue Trends und Innovationen rund um Apache Kafka und Machine Learning diskutieren [1].
Machine Learning und das Apache-Kafka-Ökosystem sind eine hervorragende Kombination für das Training und die Bereitstellung skalierbarer analytischer Modelle. Kafka wird hierbei zum zentralen Nervensystem in der ML-Architektur, um analytische Modelle mit Daten zu füttern, zu trainieren, sie für Vorhersagen anzuwenden und zu überwachen. Das bringt enorme Vorteile mit sich:
Vereinfachung von Datenpipelines
Entkopplung des Aufbaus von analytischen Modellen von deren Wartung
Nutzung von Echtzeit oder Batch nach Bedarf
Einsatz von analytischen Modellen in einer performanten, skalierbaren und unternehmenskritischen Umgebung
Da Kunden heutzutage Informationen in Echtzeit erwarten, besteht die Herausforderung für Unternehmen darin, auf Kundenanfragen und kritische Momente zu reagieren, bevor es zu spät ist. Dafür reicht Batch Processing nicht mehr aus – es muss sofort reagiert werden können, besser noch: proaktiv. Nur so kann man sich vom Mitbewerber abheben. Durch Machine Learning können bestehende Geschäftsprozesse verbessert und datengetriebene Entscheidungen automatisiert getroffen werden. Beispiele für solche Anwendungsfälle sind Betrugserkennung, Cross Selling oder die vorausschauende Wartung von IoT-Geräten (Predictive Maintenance). Die Architektur solch unternehmenskritischer Echtzeitanwendungen, die das Apache-Kafka-Ökosystem als skalierbares und zuverlässiges zentrales Nervensystem für ihre Daten nutzen, lässt sich wie in Abbildung 1 darstellen.
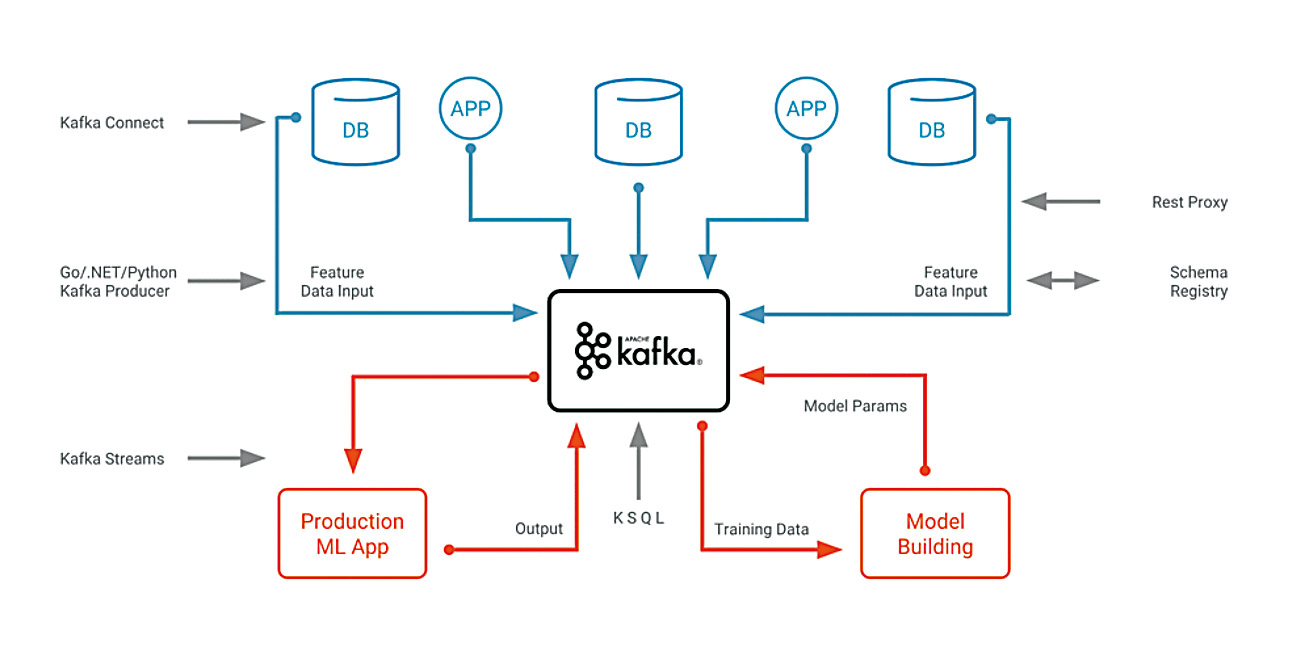 Abb. 1: Beispiel für unternehmenskritische Echtzeitanwendungen
Deployment von analytischen Modellen
Sehr generell gesprochen besteht ein Lebenszyklus für maschinelles Lernen aus zwei Teilen:
Training des Modells: In diesem Schritt befüllen wir einen Algorithmus mit historischen Daten, um Muster aus der Vergangenheit zu lernen. Das Ergebnis ist ein analytisches Modell.
Erstellung von Prognosen/Vorhersagen: In diesem Schritt verwenden wir das analytische Modell, um Vorhersagen über neue Ereignisse basierend auf dem erlernten Muster zu treffen.
Machine Learning ist ein kontinuierlicher Prozess, bei dem das analytische Modell im Laufe der Zeit immer wieder verbessert und neu aufgesetzt wird. Prognosen können innerhalb einer Anwendung oder eines Microservice auf unterschiedliche Weise durchgeführt werden. Eine Möglichkeit besteht darin, ein analytisches Modell direkt in eine Stream-verarbeitende Anwendung einzubetten, wie beispielsweise eine Anwendung, die Kafka Streams verwendet. Sie können beispielsweise das TensorFlow for Java API verwenden, um Modelle zu laden und in Echtzeit anzuwenden (Abb. 2).
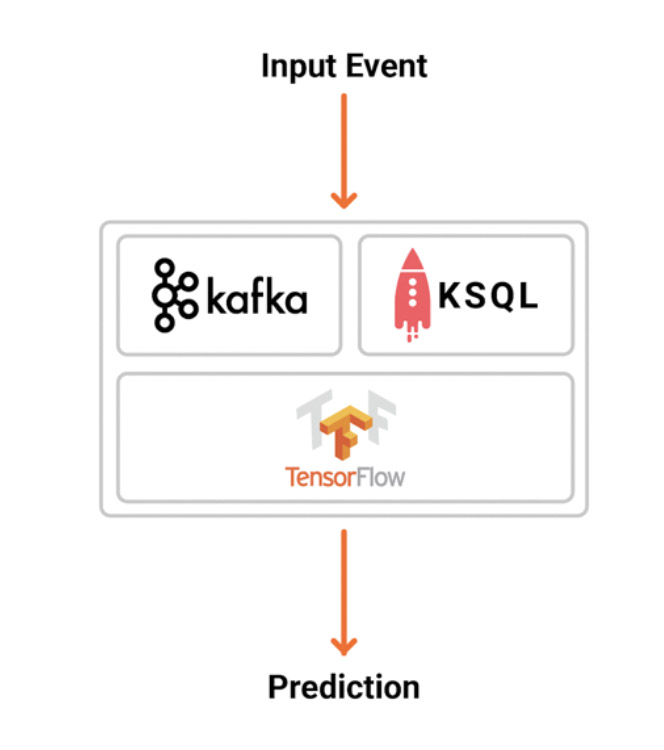 Abb. 2: Beispiel für die Verwendung des TensorFlow for Java API
Alternativ können Sie die analytischen Modelle auf einem dedizierten Modellserver (z. B. TensorFlow Serving) bereitstellen und Remote Procedure Calls (RPC) von der Streaminganwendung zum Service verwenden (z. B. mit HTTP oder gRPC) (Abb. 3).
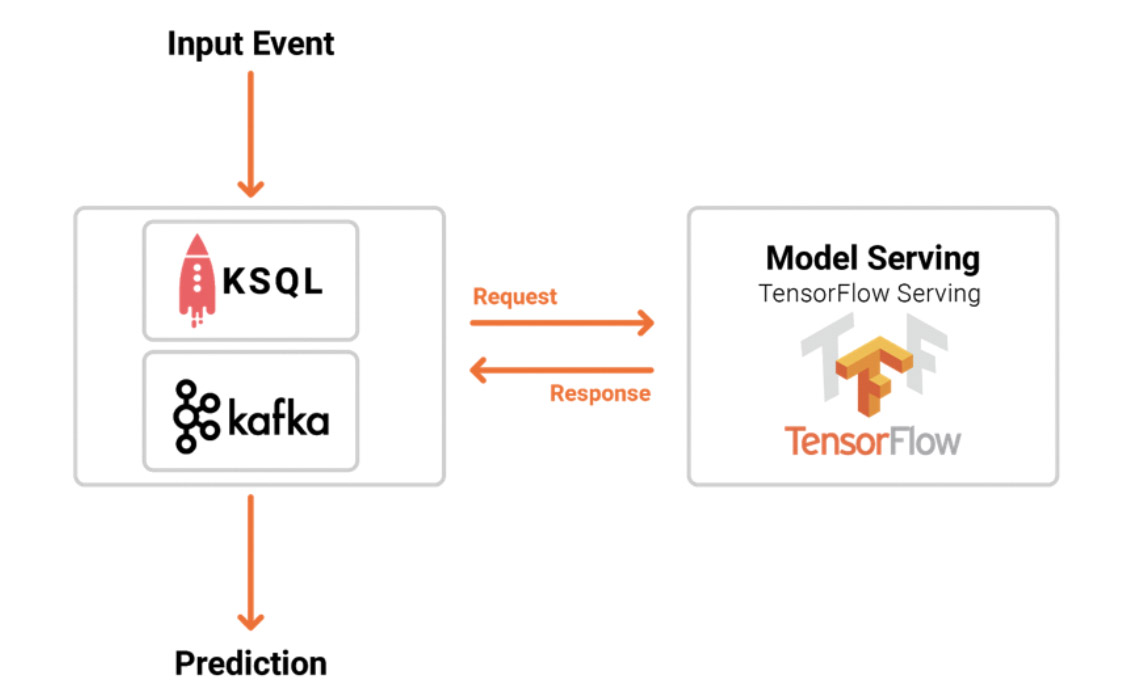 Abb. 3: Bereitstellung der analytischen Modelle auf einem dedizierten Modellserver
Beide Optionen haben ihre Vor- und Nachteile. Die Vorteile eines dedizierten Mailservers:
Einfache Integration in bestehende Technologien und Unternehmensprozesse
Einfacher zu verstehen, wenn Sie aus der „nicht-streamenden Welt“ kommen
Eine spätere Migration zu „echtem“ Streaming ist möglich
Modellverwaltung inkludiert den Einsatz verschiedener Modelle, einschließlich Versionierung, A/B-Tests etc.
Die Nachteile eines dedizierten Modellservers:
Häufig an spezifische ML-Technologien gebunden
Oft an einen bestimmten Cloud-Provider gebunden (Vendor Lock-in)
Höhere Latenzzeit
Komplexere Sicherheitskonzepte (Fernkommunikation über Firewalls und Berechtigungsmanagement)
Keine Offlineinferenz (Geräte, Kantenverarbeitung etc.)
Verbindet die Verfügbarkeit, Skalierbarkeit und Latenz/Durchsatz Ihrer Stream-Processing-Anwendung mit den SLAs der RPC-Schnittstelle
Nebeneffekte (z. B. im Störungsfall bei Netzwerkproblemen), die nicht durch die Kafka-Verarbeitung abgedeckt sind (z. B. Exactly-once Processing)
Wie analytische Modelle bereitgestellt werden, gilt es in jedem Szenario einzeln zu entscheiden – einschließlich Überlegungen zu Latenz und Sicherheit. Einige der nachfolgend diskutierten Trends wie hybride Architekturen oder Anforderungen mit niedriger Latenzzeit fordern ebenfalls Überlegungen zur Modellbereitstellung: Setzen Sie beispielsweise Modelle lokal in Edge-Komponenten wie Sensoren oder mobilen Geräten ein, um personenbezogene Daten zu verarbeiten, oder integrieren Sie externe AutoML-Dienste, um die Vorteile und Skalierbarkeit von Cloud Services...










